Golang
设计哲学
- Effective Go
- Go at Google
- Go Concurrency Patterns: Pipelines and cancellation
- Go Concurrency Patterns - Rob Pike
- Concurrency in Go,中文版
Less is more:编译为本地机器码、带垃圾回收、静态类型;一套极简的语法(仅 25 个关键字);以 CSP 为蓝本的并发;以组合而非继承为骨架的类型系统;以及对工具链与构建速度的 极度重视。
基础
数据类型
bool                                          // 不允许将布尔型强制转换
string                                        // go 中通过反引号`表示语法块
int  int8  int16  int32(rune)  int64          // go 中不允许将整型强制转换为布尔型;rune 代表了一个 Unicode 字符
uint uint8(byte) uint16 uint32 uint64 uintptr // byte 代表一个 ASCII 字符;由于 uint8 的取值范围是 0~255,因此也可以很好的表示 RGB 十进制的取值范围;uintptr 被设定为足够存放一个指针
                                              // int 与 uint 自适应 32 与 64 位平台
byte                                          // uint8 的别名,表示一个 ASCII 字符
rune                                          // int32 的别名,表示一个 Unicode 码点(UTF-8 字符)
float32 float64                               // 应该尽可能使用 float64,因为 math 包中所有有关数学运算的函数都会要求接收这个类型
                                              // float32 占用 4 字节(单精度),float64 则占用 8 字节(双精度),指数和小数默认为 float64
complex64 complex128                          // 复数类型,分别表示 32/64 位实数和虚数,complex128 为复数的默认类型
值类型与引用类型:
- 值类型:基本类型(
int、float64、bool、byte、rune等)、string、array、struct、复数; - 引用类型:
slice、map、channel、pointer、function、interface。引用类型的零值为nil
在 Go 中,值分配在栈还是堆是由编译器逃逸分析确定的,而非简单通过数据类型确定。比如体积很大的数组、在闭包中被捕获并修改的变量、指针被返回、变量在返回后被引用等情况,都会被分配到堆上。
slice、map、function 类型不能比较,只能和nil比较。
常见使用坑点:
map:未用make初始化的nil map可以安全读取,但写入(m[k] = v)会直接引发panic。channel:对nil channel进行读写会导致永久阻塞(非 panic);close(nil)会引发panic。- 指针 / 函数 / 接口:未初始化的
nil值在执行解引用 (*p)、直接调用 (fn()) 或调用接口方法 (i.Method()) 时会引发panic。 slice:nil slice可以安全使用append()追加元素,无需特意make。
一切都是值传递
Go 中所有的函数参数传递都是值传递,要么是值的副本,要么是指针的副本(引用类型的底层结构包含指针,因此会复制指针传递)。
在 Go 中,只有 sync.Map、sync.Pool、channel、atomic 是并发安全的,大多数类型都不是并发安全的,并发读写时需要通过 sync.Mutex、sync/atomic、channel 等手段进行同步保护。
字符串构建
strings.Builder 用于专门高效构建字符串,bytes.Buffer 则用于通用字节流缓冲,由于实现了 io.Reader 和 io.Writer 接口,支持 Read()、Write()、Bytes()、String() 等方法。两者都避免了多次创建新 string 的性能损耗。
| strings.Builder | bytes.Buffer |
|---|---|
|
|
struct
struct 可以当作面向对象中的类:
- 结构体里的字段(field)≈ 类的属性(成员变量)
- 绑定在结构体上的方法(method)≈ 类的方法(成员函数)
- 结构体实例(instance)≈ 类创建出来的对象(object)
struct{} 是空结构体类型,不占用内存空间,常见用法:
- 用
map[K]struct{}模拟 set(零内存开销的 value) - 用
chan struct{}作为纯信号通道
make & new
make() 用于初始化并分配内存,new() 只分配内存但不初始化。
make() |
new() |
|
|---|---|---|
| 适用类型 | 引用类型:slice、map、channel |
值类型:int、string、struct 等 |
| 返回值 | 已初始化的类型本身 | 指向零值的指针 *T |
| 使用频率 | 常用 | 极少(var 声明已自动初始化为零值) |
注意:
- 引用类型零值为
nil,未经make初始化直接赋值会引发panic: assignment to entry in nil map cap()查看容量,len()查看长度(均适用于make类型)for...range可遍历所有make类型:slice/array:返回(index, value)map:返回(key, value)channel:返回(value, ok),ok表示通道是否已关闭
defer
在 Go 中,return 并不是一个原子操作,它的执行过程可以拆分为以下三个步骤:
- 返回值赋值(将返回值写入保存返回值的内存区域)
- 执行
defer函数(按后进先出 LIFO 的顺序依次执行) - 真正的函数返回(执行汇编指令 RET,将控制权交还给调用者)
因此,defer 的执行时机介于“返回值赋值”和“真正的函数返回”之间。
| 匿名返回值 | 具名返回值 | 返回值为指针 |
|---|---|---|
|
|
|
interface
Go 中接口类型的值才会同时存储「类型信息 + 值信息」,而其他类型在编译期就已经确定,运行时不需要再带类型信息。
Go 中常见的接口类型有:error、io.Reader/io.Writer、context.Context、http.Handler、json.Marshaler/json.Unmarshaler。
Go 中的接口是隐式实现。
鸭子类型
如果一个东西走起来像鸭子,叫起来像鸭子,游泳也像鸭子,那么我们就把它当作鸭子。
意思是:不用检查鸭子的身份证,只看它表现出来的行为。不需要声明实现接口,只看方法是否满足接口要求。
Go 中的接口值时钟可以用==比较(编译期不会报错),但结果取决于底层动态类型和值:
| 情况 | 结果 |
|---|---|
两个都是 nil |
true |
| 动态类型不同 | false(不 panic) |
| 动态类型相同且类型可比较 | 比较动态值,返回 true / false |
动态类型相同但类型不可比较(如 slice、map、func) |
runtime panic ⚠️ |
反射
Go 中的反射通过接口实现,一个接口变量分别包含指向类型信息和实际数据的指针。当我们将一个具体类型的变量赋值给一个接口时,Go 语言就可以通过 reflect 包的 TypeOf 和 ValueOf 这两个函数读取接口变量里的类型信息和数据信息。
常见的反射应用:
- JSON 序列化: 通过反射动态获取结构体字段信息,实现任意类型的序列化和反序列化。
- ORM(对象关系映射): 通过反射动态构建 SQL 语句,实现任意结构体的数据库操作。
- Web 框架参数绑定: 如 Gin 框架的
ShouldBind方法,能够根据请求类型自动将 HTTP 参数绑定到结构体字段上,这背后就是通过反射实现的类型转换和赋值。 - 配置文件解析、RPC 调用、测试框架等: Viper 配置库用反射将配置映射到结构体,gRPC 通过反射实现服务注册和方法调用。
接收者
在以下情况使用指针接收者:
- 需要修改接收者的内部状态 / 字段
- 结构体体积较大(性能考虑)
- 结构体包含“不可复制”的字段(如并发锁)
- 如果一个类型中有“至少一个”方法使用了指针接收者,那么该类型的“所有方法”都应该统一使用指针接收者。
Go 官方建议:如果不确定用哪个,优先选择指针接收者。
channel
channel 在 Go 中有多种应用场景:
子 Goroutine 任务完成后,通过 Channel 向主 Goroutine 发送信号。
func main() {
    done := make(chan struct{}) // 使用 struct{} 不占内存

    go func() {
        fmt.Println("正在处理后台任务...")
        time.Sleep(1 * time.Second)
        done <- struct{}{} // 发送完成信号
    }()

    <-done // 阻塞等待信号
    fmt.Println("任务完成,主程序退出")
}
生产者-消费者模式和 Worker Pool(工作池) 模式,分发 N 个任务给 M 个 Worker,并通过 Channel 汇总所有 Worker 的处理结果。
func worker(id int, jobs <-chan int, results chan<- int) {
    for j := range jobs { // 自动消费直至 jobs 被 close
        results <- j * 2 // 收集计算结果
    }
}

func main() {
    jobs := make(chan int, 100)
    results := make(chan int, 100)

    // 启动 3 个 worker
    for w := 1; w <= 3; w++ {
        go worker(w, jobs, results)
    }

    // 下发 5 个任务
    for j := 1; j <= 5; j++ {
        jobs <- j
    }
    close(jobs) // 关闭任务通道,通知 worker 退出

    // 收集 5 个结果
    for a := 1; a <= 5; a++ {
        fmt.Println("Result:", <-results)
    }
}
func main() {
    maxConcurrency := 3
    sem := make(chan struct{}, maxConcurrency) // 限制最大并发数为 3

    for i := 1; i <= 10; i++ {
        sem <- struct{}{} // 缓冲区满时会阻塞,实现并发控制
        go func(id int) {
            defer func() { <-sem }() // 任务完成后释放令牌

            fmt.Printf("正在执行任务 %d\n", id)
            time.Sleep(1 * time.Second)
        }(i)
    }
}
type Mutex chan struct{}

func NewMutex() Mutex {
    ch := make(chan struct{}, 1)
    ch <- struct{}{} // 放入一把钥匙
    return ch
}

func (m Mutex) Lock()   { <-m } // 抢钥匙
func (m Mutex) Unlock() { m <- struct{}{} } // 归还钥匙
close 的语义就是发送方宣告「我发完了」,不是资源释放——channel 和普通对象一样由 GC 回收,不关也不泄漏。
需要调用 close 的 3 种情况:
- 接收方用
for range或v, ok := <-ch,因为range会一直循环到 channel 关闭为止,不关就是死锁 - 广播退出信号,因为关闭是唯一能一次唤醒 N 个接收者的手段,发送做不到(发一次只有一个人收到)
- 多路 select 里需要感知某个源结束
引发 panic
- 数组越界
- 空指针解引用
- 对 nil map 写入
- 向已关闭的 channel 发送
- 重复关闭 channel
- WaitGroup 负计数
发生panic时可以使用recover捕获,比如处理用户请求时,捕获panic并返回 500。
闭包
闭包引用的外部变量会发生逃逸。
使用场景:
- goroutine 携带上下文
- 保存计数器
- HTTP 中间件
标准库
文本与字符串
fmt:格式化输出,常用函数fmt.Println(),fmt.Sprintf(),fmt.Printf(),fmt.Errorf()
fmt 中常用占位符
以下占位符可用在fmt 包中所有以 f 结尾的函数中,如输出(fmt.Printf, fmt.Sprintf, fmt.Fprintf),输入(fmt.Scanf, fmt.Sscanf, fmt.Fscanf)和错误(fmt.Errorf)中。
- 通用:
%v:默认格式输出值%+v:输出结构体时附带字段名%#v:输出值的 Go 语法表示(如main.User{Name:"Tom", Age:18})%T:输出值的类型(如int,string,main.User)%%:输出字面量%
- 布尔:
%t:输出true或false
- 整数:
%d:十进制整数%b:二进制整数%o:八进制整数%x:十六进制整数(小写字母 a-f)%X:十六进制整数(大写字母 A-F)%c:对应 Unicode 码点的字符%U:Unicode 格式(如U+0041)
- 浮点数:
%f:浮点数(默认精度)%e:科学计数法(小写 e)%E:科学计数法(大写 E)%g:根据值的大小自动选择%e或%f
- 字符串与字节切片:
%s:字符串或[]byte的原始内容%q:带双引号的字符串(Go 语法转义)%x:十六进制编码(每字节两个字符)
- 指针:
%p:指针地址(十六进制,带0x前缀)
- 宽度与精度:
%9d:最小宽度 9,右对齐%-9d:最小宽度 9,左对齐%09d:最小宽度 9,用0填充%.2f:浮点数保留 2 位小数
strings:字符串处理,常用函数strings.Builder:字符串构建器,避免多次创建新的 stringstrings.Contains():判断字符串是否包含另一个字符串strings.Split():分割字符串strings.Join():连接字符串strings.ReplaceAll():替换字符串strings.HasPrefix():判断字符串是否以某个前缀开头
strconv:字符串与基本类型间的类型转换strconv.Atoi():字符串转整数strconv.Itoa():整数转字符串strconv.ParseInt():字符串转整数strconv.FormatFloat():浮点数转字符串
bytes:处理[]byte切片regexp:正则表达式
错误处理
errors:errors.New():创建一个新的错误errors.Is():判断错误链中是否存在某个错误errors.As():提取错误链中的特定错误类型errors.Join():合并多个错误
并发控制
sync:常用并发原语sync.Mutex:互斥锁sync.RWMutex:读写锁,适用于读多写少的场景,读并发性能更好sync.Once:保证某段代码只执行一次,常用于单例初始化sync.WaitGroup:等待一组 goroutine 全部完成sync.Map:并发安全的 mapsync.Pool:并发安全的对象池,可复用临时对象以减少 GC 压力,如在高并发 HTTP 服务中复用bytes.Buffersync.Cond:条件变量,与锁(sync.Mutex/sync.RWMutex)配合使用,用于 Goroutine 间的等待与通知同步(支持单发Signal()和广播Broadcast()),在需要重复广播时使用
sync/atomic:原子操作,常用函数atomic.AddInt64(),atomic.LoadInt64(),atomic.CompareAndSwapInt64()context:在 goroutine 间传递截止时间、取消信号和请求级数据context.Background():返回空的根 context,通常作为顶层起点context.WithTimeout():创建带超时时间的 context,到期自动取消context.WithDeadline():创建带截止时间的 context,到期自动取消context.WithCancel():创建可手动取消的 contextcontext.WithValue():创建携带键值对的 context,用于传递请求级数据
文件系统
io:最核心的 I/O 抽象接口,如io.Reader,io.Writer,io.Closer,常用函数io.ReadAll(),io.Copy()os:跨平台的文件操作、环境变量读取、进程交互等,常用函数os.Open(),os.ReadFile(),os.WriteFile(),os.Getenv(),os.MkdirAll()bufio:包装io.Reader/io.Writer提供带缓冲区的读写,常用函数bufio.NewScanner(),bufio.NewReader()path/filepath:处理文件路径,如filepath.Join(),filepath.Split(),filepath.Abs(),filepath.Ext()
网络
net/http:HTTP 客户端和服务端,常用函数http.Get(),http.Post(),http.ListenAndServe(),http.HandleFunc()net:TCP、UDP、IP、Unix Socket 等网络编程,常用函数net.Listen(),net.Dial(),net.ResolveTCPAddr()net/url:URL 解析与编码,常用函数url.Parse(),url.QueryEscape(),url.QueryUnescape()
序列化与编码
encoding/json:常用函数json.Marshal(),json.Unmarshal()encoding/base64encoding/xmlencoding/csvencoding/hex
slices/maps
slices:slices.Contains():判断切片是否包含某个元素slices.Sort():对切片进行排序slices.Compact():对切片进行去重slices.Compare():逐元素比较两个切片,返回 0(相等)、-1(s1 < s2)或 +1(s1 > s2)
maps:maps.Keys():返回 map 所有键组成的切片(顺序不固定)maps.Values():返回 map 所有值组成的切片maps.Clone():浅拷贝一个 mapmaps.Copy(dst, src):将 src 中所有键值对复制到 dstmaps.Equal(m1, m2):判断两个 map 是否包含相同的键值对
时间与数值计算
time:time.Now():获取当前时间time.NewTimer():单次触发,通过timer.C接收到期信号,使用后需调用timer.Stop()释放资源time.NewTicker():定时触发,返回<-chan Time,使用后需Ticker.Stop()释放资源time.After():一段时间后触发,返回<-chan Time,不可复用time.Sleep():休眠一段时间time.Since():计算时间差,返回Durationtime.Duration:时间间隔
math:math.MaxInt64,math.MaxFloat64,math.Pi,math.E等常量math.Abs(),math.Pow(),math.Sqrt()等数学函数
math/rand/v2:普通业务逻辑的随机数生成,如生成随机数验证码、抽奖等crypto/rand:密码学安全的随机数生成,如生成 UUID、密钥、加密随机数等
日志
log/slog:结构化日志库(支持 JSON 格式输出、日志级别控制、Key-Value 键值对日志)
运行时
flag:Go 标准库的flag包可满足基本的命令行参数解析需求,但缺乏必填参数校验、短选项/长选项别名等功能。实际项目中通常选用功能更完整的第三方库spf13/cobra。reflect:在运行时动态检查变量类型、获取结构体 Tag、动态调用方法(如 ORM 框架和序列化框架大量使用)runtime:运行时信息与控制runtime.NumGoroutine():当前活跃的 goroutine 数量runtime.NumCPU():当前机器的逻辑 CPU 数量runtime.GOMAXPROCS(n):设置可并行执行的最大 CPU 数,传 0 仅查询不修改runtime.Gosched():主动让出当前 goroutine 的 CPU 时间片runtime.GC():手动触发一次 GCruntime.Stack(buf, all):将当前 goroutine(或所有 goroutine)的调用栈写入 buf
测试
testing:Go 内置测试框架,核心类型为testing.T(单元测试)、testing.B(基准测试)、testing.F(模糊测试),但缺少断言函数,实际项目中通常搭配第三方库github.com/stretchr/testify使用:testify/assert:断言失败后继续执行后续测试testify/require:断言失败后立即终止当前测试testify/mock:生成 mock 对象,用于隔离外部依赖
自带工具
run:编译并运行当前模块test:支持单元测试(TestXxx)、基准性能测试(BenchmarkXxx)、模糊测试(FuzzXxx)、代码覆盖率(-cover)、竞态检测(-race)build-ldflags:传递参数给链接器-X:动态注入变量值,如版本号、构建时间-w:去掉 DWARF 调试信息-s:移除符号表和调试信息
-race:开启竞态检测-gcflags:传递参数给 Go 编译器-m:变量逃逸分析
-trimpath:移除源码路径(推荐生产环境使用)-x:打印编译时调用的底层指令
modinit:初始化模块(生成 go.mod)tidy:整理依赖(自动增删无用包)vendor:将依赖拷贝到 vendor 目录download:手动下载依赖包verify:校验模块校验和
get:添加、修改或升级项目的第三方依赖版本,并更新 go.modfmt:格式化代码vet:静态代码分析工具,检查潜在的代码问题(如错误的 Printf 格式化参数、sync.Mutex被值拷贝等锁误用)env:查看或修改 Go 的环境变量install:将二进制文件安装到$GOPATH/bin(或$GOBIN)目录下,常用于安装 CLI 工具toolpprof:CPU、内存(Heap)、Goroutine、阻塞(Block)等性能分析工具,可以生成交互式命令行或 Web 架构的分析图表trace:可视化执行追踪工具,可以通过浏览器查看具体的 Goroutine 调度、垃圾回收(GC)暂停时间以及网络 I/O 阻塞情况cover:将go test -coverprofile生成的覆盖率文件渲染为 HTML 网页,直观查看哪行代码没被测试覆盖到compile:Go 编译器,可用于查看汇编代码(如go tool compile -S main.go)link:Go 链接器cgo:处理 Go 与 C 语言互操作的工具nm:查看二进制文件中的符号表objdump:对 Go 二进制文件进行反汇编addr2line:将二进制文件的指令地址转换为源码对应的文件名和行号
generate:配合代码中的//go:generate注释,自动触发代码生成脚本(如生成枚举映射、Protobuf 代码等)work:方便在本地同时修改和调试多个相互依赖的 Go 模块clean:清理编译产生的临时文件、对象文件和缓存fix:自动修复(不推荐直接使用,容易破坏代码逻辑)
底层原理
slice
// runtime/slice.go
type slice struct {
        array unsafe.Pointer // 元素指针
        len   int // 长度
        cap   int // 容量
}
slice 是底层数组的一个窗口。如果 slice 引用了一个大数组的片段,即使只用到其中很小一部分,整个大数组也无法被 GC 回收。可以用 copy() 复制所需数据来断开引用。
append 在容量足够时不会分配新数组,而是直接在底层数组上写入,可能意外修改其他共享该数组的 slice:
s := []int{10, 20, 30, 40, 50}
s1 := s[1:3]          // s1: [20, 30], len=2, cap=4
s1 = append(s1, 60)   // s1: [20, 30, 60], 修改了底层数组 s
s2 := s[2:4]          // s2: [30, 60], s: [10, 20, 30, 60, 50]
需要注意的是,s[a:b:c] 这样的写法,c 在 Python 中表示步长,而 Go 中表示容量上界索引,结果 slice 的 cap = c - a。这常用于限制 slice 容量,防止 append 意外覆盖底层数组的后续元素。
三段式切片可以超出 len 但不能超出 cap
对 slice 再次切片时,索引上界是 cap 而非 len,因此可以「看到」原 slice 长度之外、容量之内的元素:
slice := []int{0, 1, 2, 3, 4, 5, 6, 7, 8, 9}
s1 := slice[2:5]  // [2, 3, 4],        len=3, cap=8
s2 := s1[2:6:7]   // [4, 5, 6, 7],     len=4, cap=5
//         ↑ 超出了 s1 的 len(3),但未超出 cap(8)
map
Map 的核心结构包括 hmap 和 bmap。它在运行时表现为一个指向 hmap 结构体的指针,hmap 中记录了桶数组指针 buckets、溢出桶指针以及元素个数等字段。每个桶是一个 bmap 结构体,能存储 8 个键值对和 8 个 tophash,并有指向下一个溢出桶的指针 overflow。为了内存紧凑,bmap 中采用的是先存 8 个键再存 8 个值的存储方式。
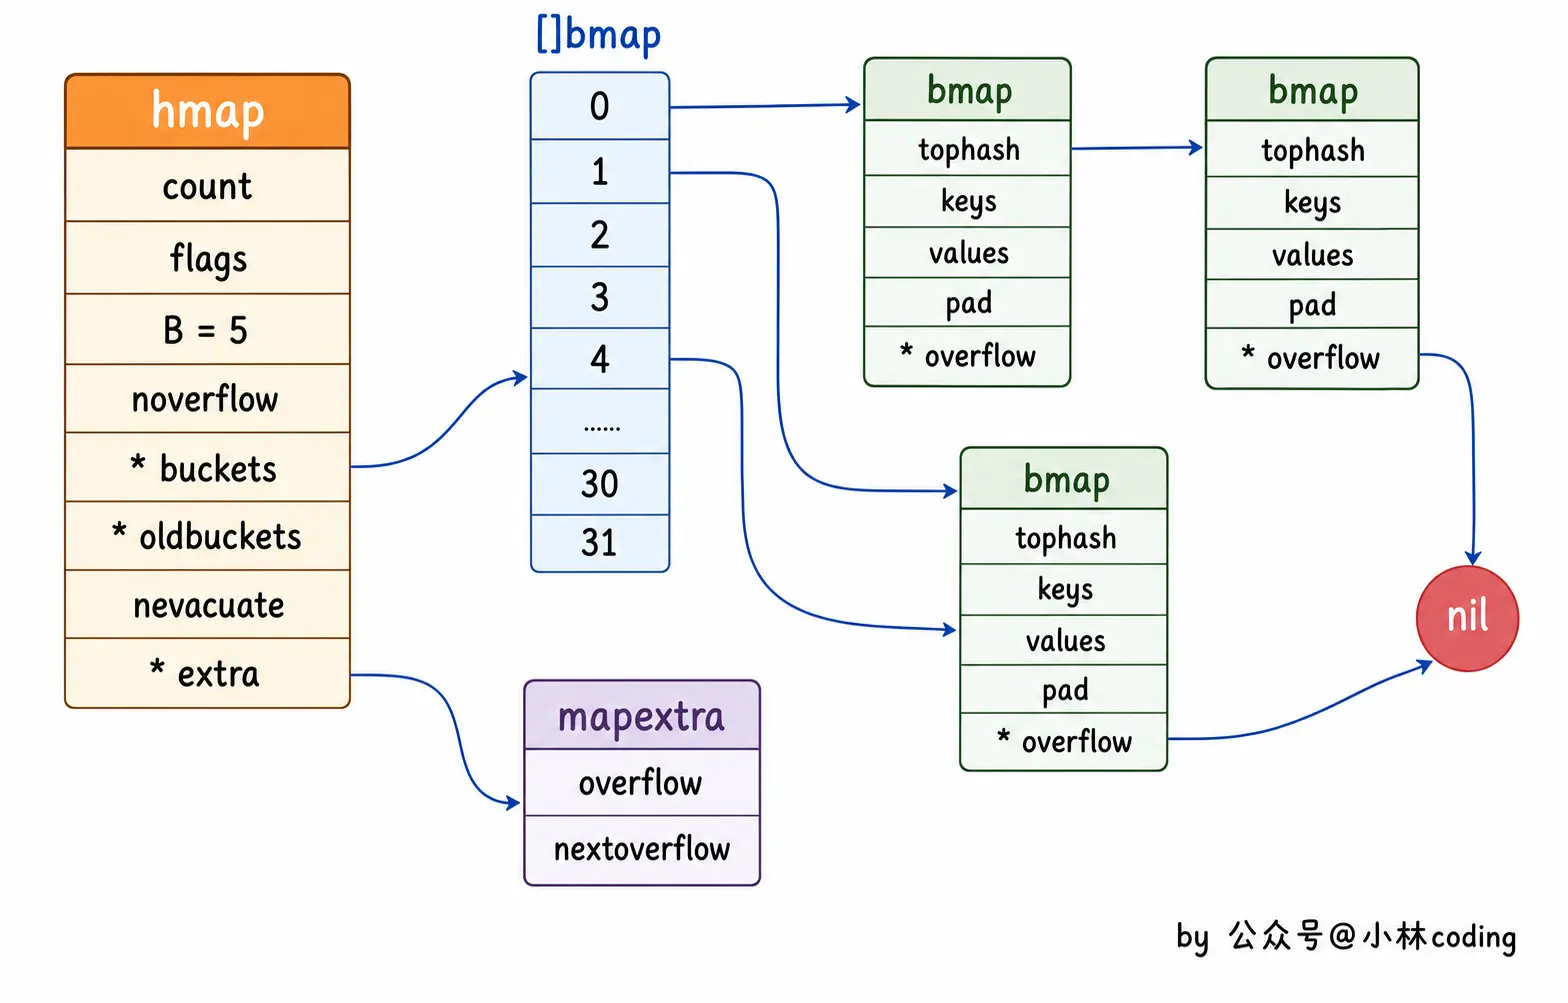
hmap 结构 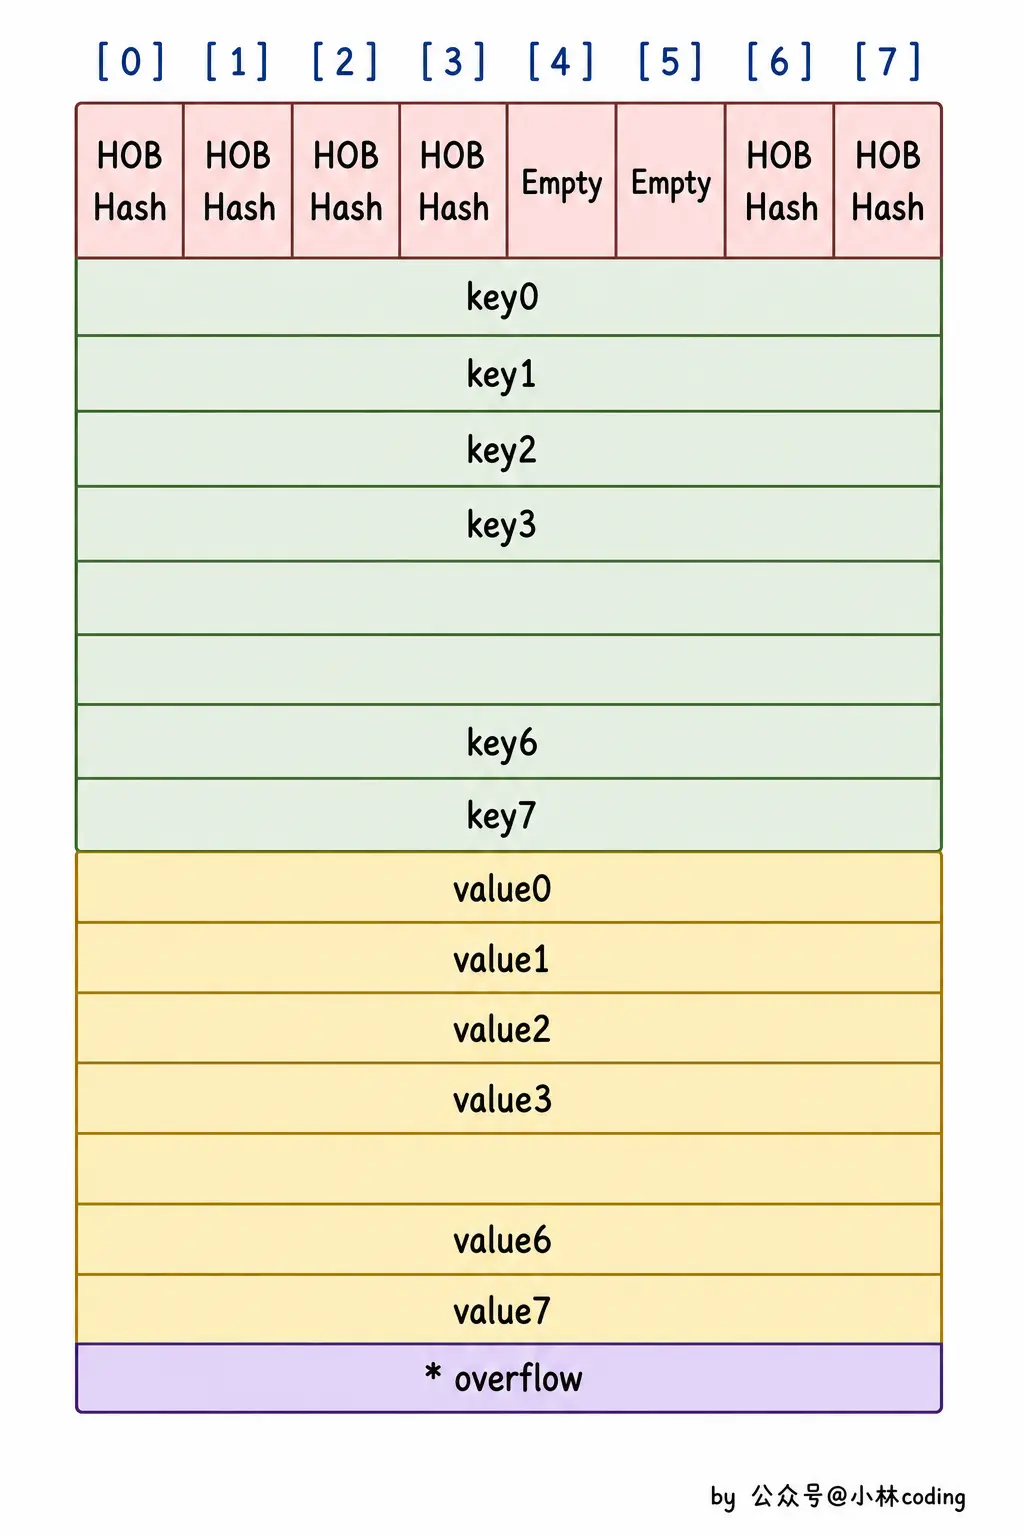
bmap 结构
// A header for a Go map.
type hmap struct {
   count     int    // map 中元素个数
   flags     uint8  // 状态标志位,标记 map 的一些状态
   B         uint8  // 桶数以 2 为底的对数,即 B=log_2(len(buckets)),比如 B=3,那么桶数为 2^3=8
   noverflow uint16 // 溢出桶数量近似值
   hash0     uint32 // 哈希种子

   buckets    unsafe.Pointer // 指向 buckets 数组的指针
   oldbuckets unsafe.Pointer // 是一个指向 buckets 数组的指针,在扩容时,oldbuckets 指向老的 buckets 数组 (大小为新 buckets 数组的一半),非扩容时,oldbuckets 为空
   nevacuate  uintptr        // 表示扩容进度的一个计数器,小于该值的桶已经完成迁移

   extra *mapextra // 指向 mapextra 结构的指针,mapextra 存储 map 中的溢出桶
}
由于 map 扩容会发生 key 的搬迁,导致顺序不稳定,因此 Go 在遍历时引入随机数,避免开发者依赖 map 的遍历顺序。
哈希冲突时需要比较 key 来定位正确的键值对,因此 map 的 key 必须是可比较的类型(支持 ==),如 slice、map、func 不能作为 key。
map 插入新 key 时,如果符合以下条件,则会触发扩容:
- 装载因子超过阈值时,触发双倍扩容
- overflow 的 bucket 数量过多时,触发等量扩容
map 的扩容是渐进式的,会在每次写入操作时,搬迁一两个旧桶的数据,以便分摊扩容开销,避免单次操作延迟过高。
**无法对 map 的 key 或 value 进行取址,会发生编译报错。**这样设计主要是因为 map 一旦发生扩容,key 和 value 的位置就会改变,之前保存的地址也就失效了。
channel
CSP(Communicating Sequential Processes,通信顺序进程)并发编程模型,其核心思想是:通过通信共享内存,而不是通过共享内存来通信。Go 语言的 Goroutine 和 Channel 机制,就是 CSP 的经典实现,
Channel 的底层是一个名为hchan的结构体,核心包含几个关键组件:
- 环形缓冲区(暂存数据):有缓冲 channel 内部维护一个固定大小的环形队列,用
buf指针指向缓冲区,sendx和recvx分别记录发送和接收的位置索引。这样设计能高效利用内存,避免数据搬移。 - 等待队列(暂存阻塞的 goroutine):
sendq和recvq用来管理阻塞的 goroutine。sendq存储因 channel 满而阻塞的发送者,recvq存储因 channel 空而阻塞的接收者。这些队列用双向链表实现,当条件满足时会唤醒对应的 goroutine。 - 互斥锁(并发安全):
hchan内部有个mutex,所有的发送、接收操作都需要先获取锁,用来保证并发安全。虽然看起来可能影响性能,但 Go 的调度器做了优化,大多数情况下锁竞争并不激烈。
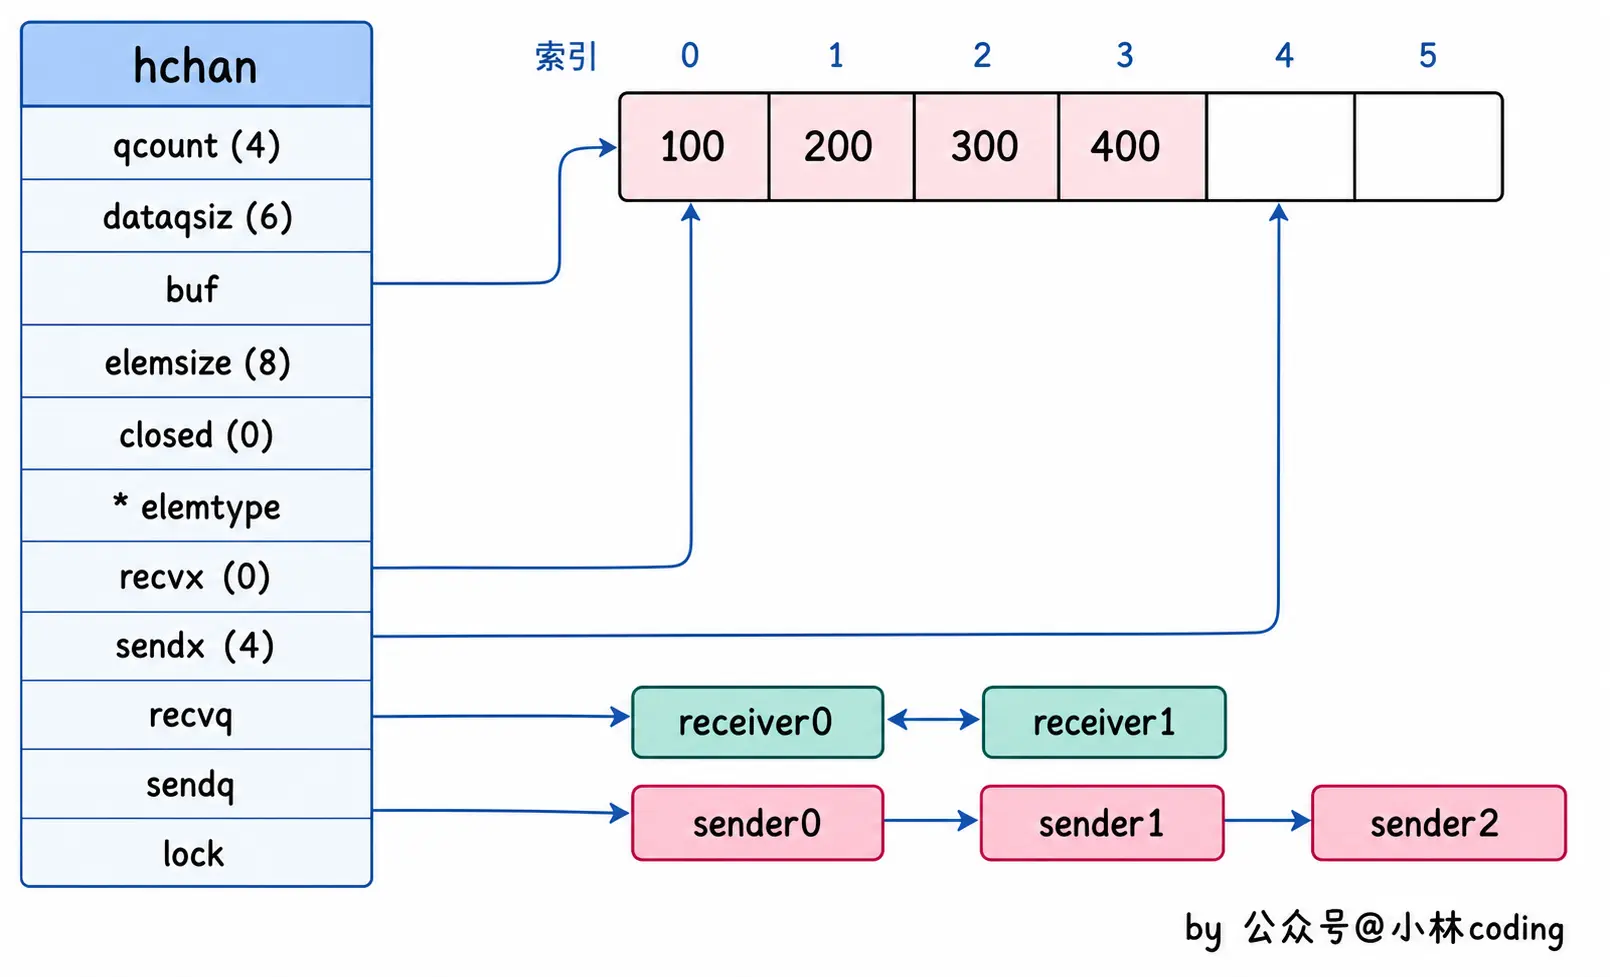
type hchan struct {
        // chan 里元素数量
        qcount   uint
        // chan 底层循环数组的长度
        dataqsiz uint
        // 指向底层循环数组的指针
        // 只针对有缓冲的 channel
        buf      unsafe.Pointer
        // chan 中元素大小
        elemsize uint16
        // chan 是否被关闭的标志
        closed   uint32
        // chan 中元素类型
        elemtype *_type // element type
        // 已发送元素在循环数组中的索引
        sendx    uint   // send index
        // 已接收元素在循环数组中的索引
        recvx    uint   // receive index
        // 等待接收的 goroutine 队列
        recvq    waitq  // list of recv waiters
        // 等待发送的 goroutine 队列
        sendq    waitq  // list of send waiters

        // 保护 hchan 中所有字段
        lock mutex
}
以容量为 2 的 buffered channel 为例,说明 channel 的发送和接收过程:
ch := make(chan int, 2) // 缓冲区大小 2
初始状态
环形缓冲区: [ _ , _ ]   sendx=0, recvx=0, qcount=0
sendq: 空
recvq: 空
- G1 发送
ch <- 10— 缓冲区有空位,数据直接写入 buf环形缓冲区: [ 10 , _ ] sendx=1, recvx=0, qcount=1 sendq: 空 recvq: 空 - G2 发送
ch <- 20— 缓冲区还有一个空位,继续写入环形缓冲区: [ 10 , 20 ] sendx=0(回绕), recvx=0, qcount=2 sendq: 空 recvq: 空 - G3 发送
ch <- 30— 缓冲区已满!G3 阻塞,挂入 sendq环形缓冲区: [ 10 , 20 ] sendx=0, recvx=0, qcount=2 sendq: [G3(数据=30)] ← G3 被挂起,连同要发送的数据一起记录 recvq: 空 - G4 接收
v := <-ch— 从 buf 取出数据,同时唤醒 sendq 中的 G31. G4 从 recvx=0 取出 10,v = 10 2. 缓冲区腾出一个位置 3. 从 sendq 取出 G3,把 G3 的数据 30 写入缓冲区 4. 唤醒 G3 环形缓冲区: [ 30 , 20 ] sendx=1, recvx=1, qcount=2 sendq: 空 ← G3 已被唤醒 recvq: 空 - G5 接收
v := <-ch— 从 buf 取出数据G5 从 recvx=1 取出 20,v = 20 环形缓冲区: [ 30 , _ ] sendx=1, recvx=0(回绕), qcount=1 sendq: 空 recvq: 空 - G6 接收
v := <-ch— 缓冲区还有数据G6 从 recvx=0 取出 30,v = 30 环形缓冲区: [ _ , _ ] sendx=1, recvx=1, qcount=0 sendq: 空 recvq: 空 - G7 接收
v := <-ch— 缓冲区空了!G7 阻塞,挂入 recvq环形缓冲区: [ _ , _ ] sendx=1, recvx=1, qcount=0 sendq: 空 recvq: [G7] ← G7 被挂起等待数据
context
Context 用于在 Goroutine 之间传递取消信号、截止时间和请求级别的元数据。
Context 接口
type Context interface {
    Deadline() (deadline time.Time, ok bool)  // 返回截止时间(绝对时间),ok 表示是否设置了截止时间
    Done() <-chan struct{}                    // 返回只读 channel,channel 关闭表示 Context 已被取消
    Err() error                               // 返回 Done 关闭的原因:被取消或超时
    Value(key any) any                        // 返回 key 对应的值
}
创建 Context
根 Context:
| 函数 | 说明 |
|---|---|
context.Background() |
默认的根 Context,用于 main、初始化和请求入口 |
context.TODO() |
占位用,暂时不确定该传哪个 Context 时使用 |
派生 Context:
| 用途 | 函数 | 说明 |
|---|---|---|
| 超时控制 | context.WithTimeout(parent, duration) |
经过指定时长后自动取消 |
| 超时控制 | context.WithDeadline(parent, time.Time) |
到达指定时间点后自动取消 |
| 主动取消 | context.WithCancel(parent) |
常用于协调多个 Goroutine 主动退出 |
| 主动取消 | context.WithCancelCause(parent) |
取消时可携带原因,通过 context.Cause(ctx) 读取 |
| 跨链路传值 | context.WithValue(parent, key, val) |
跨 API 边界传递请求级别的元数据(如 TraceID、登录用户信息) |
| 断开取消链 | context.WithoutCancel(parent) |
不随父 Context 取消,但保留其中的值。常用于请求结束后继续执行后台任务(如异步写入、发邮件),同时保留 TraceID |
| 优雅停机 | signal.NotifyContext(parent, signals...) |
捕获到指定系统信号(如 SIGINT、SIGTERM)时自动取消,常用于服务平滑退出 |
取消传播
取消信号沿 Context 的层级结构向下传播,父 Context 取消时,所有子 Context 都会自动取消,子 Context 取消则不影响父 Context。
ctx.Done() 返回的 channel 会在以下情况被关闭:
- 手动调用
cancel() - 超时或到达截止时间(
WithTimeout()、WithDeadline()) - 父 Context 被取消
- HTTP / gRPC 等场景下连接断开或请求结束,框架底层调用
cancel()
值查找
ctx.Value(key) 从当前 Context 开始,沿父 Context 链逐层向上查找,直到找到对应的 key 或到达根 Context。
sync.Map
sync.Map 适合读多写少的场景,其核心是空间换时间的思想,通过 read 和 dirty 两个 map 实现 "读写分离",最终达到针对特定场景的“读”操作无锁优化。
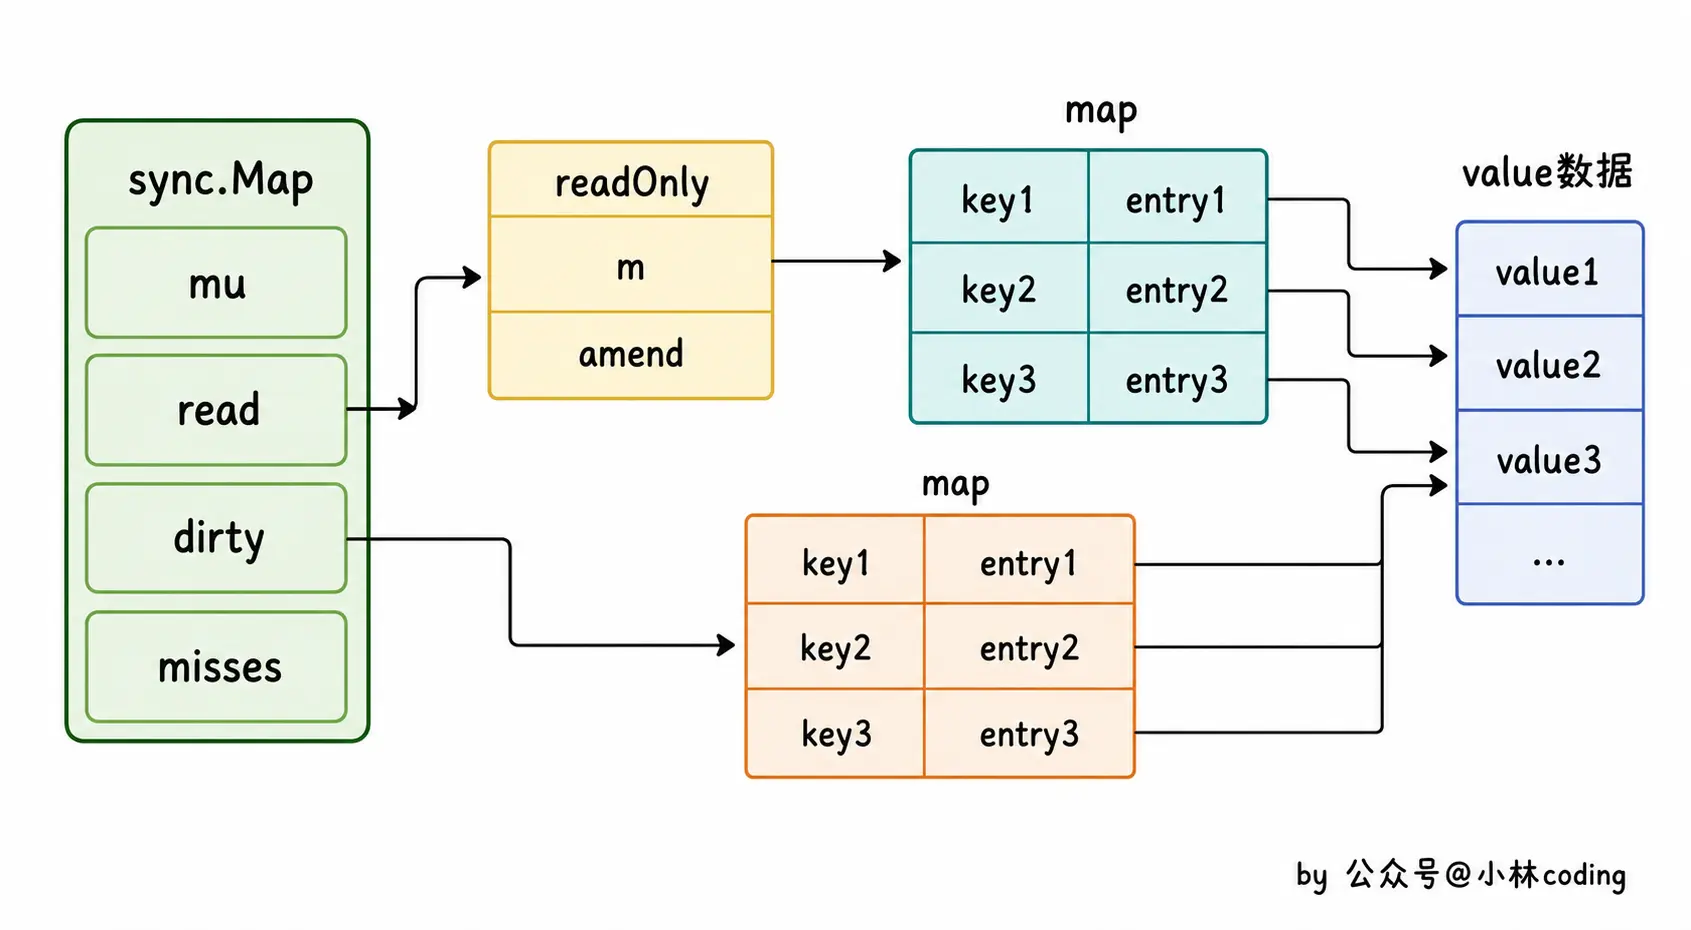
内存
Go 采用线程缓存分配(Thread-Caching Malloc,TCMalloc),将对象根据大小分类,并设计多层级(线程缓存、中心缓存、页堆)的组件提高内存分配器的性能。
| 层级 | 线程独占 | 需要锁 | 用途 |
|---|---|---|---|
| Thread Cache(mcache) | ✅ | ❌ | 每个线程(P)的小对象分配 |
| Central Cache(mcentral) | ❌ | ✅ | 共享的中层缓存 |
| Page Heap(mheap) | ❌ | ✅ | 管理大对象与页级内存 |
Go 运行时的堆内存分配机制(如 mcache 和 mcentral)是线程安全的,goroutine 间无需额外锁即可安全分配内存。
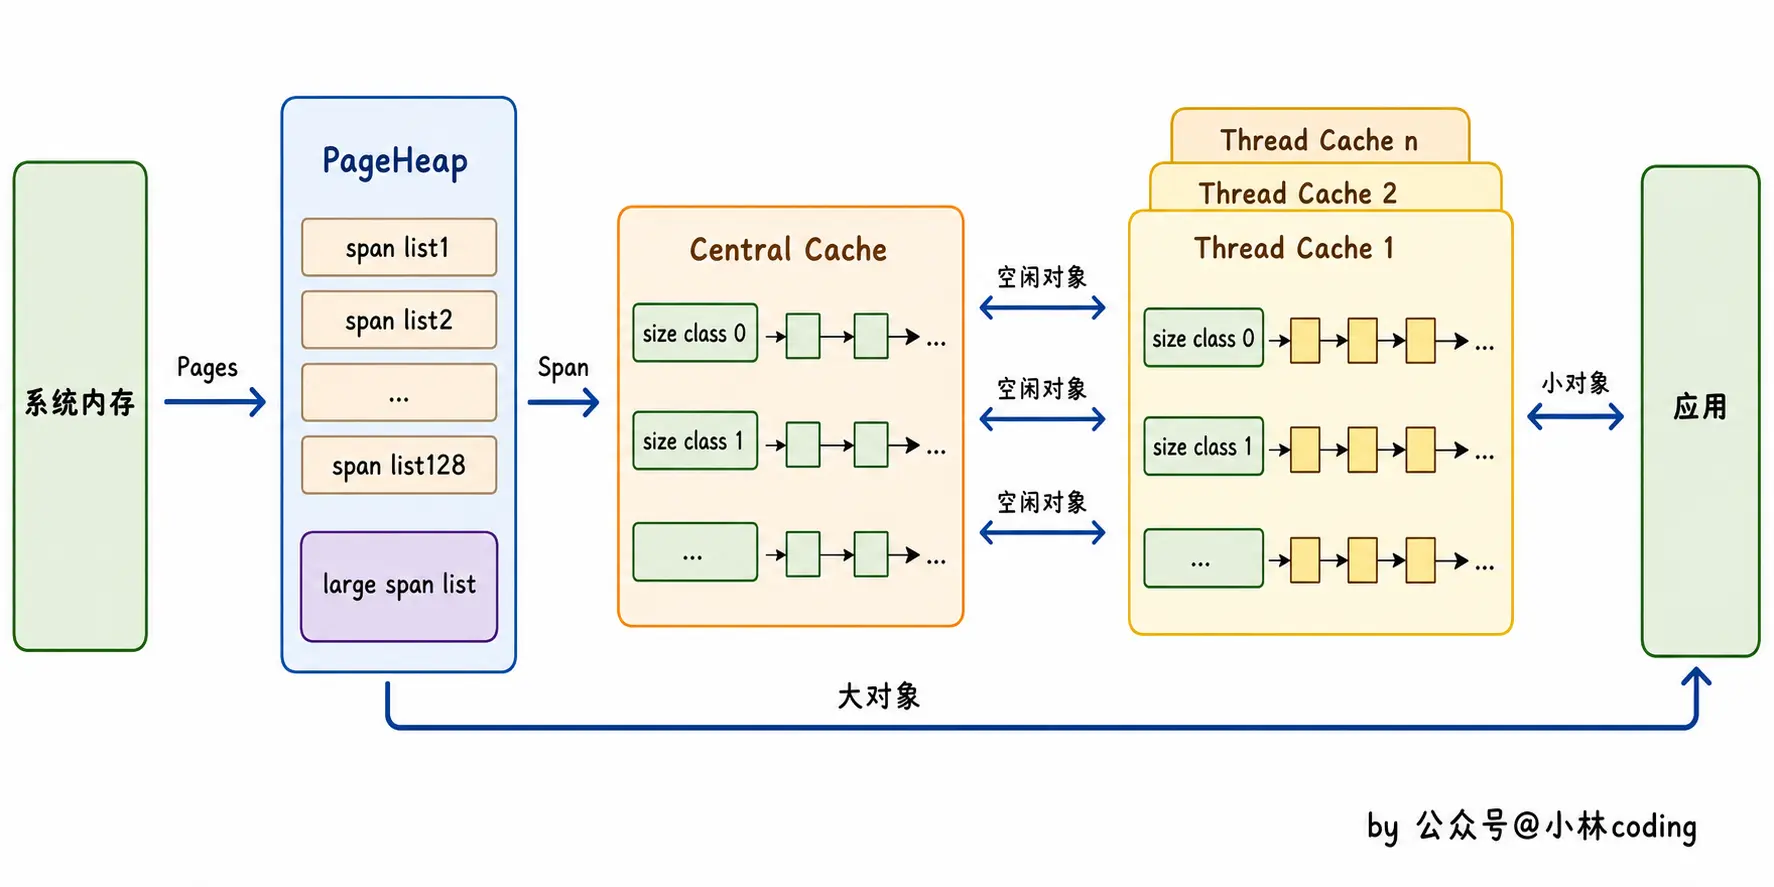
变量逃逸分析
- 函数变量的内存默认会分配在栈上,栈的分配与回收都非常迅速;堆适合不可预知大小的内存分配,可动态扩张或缩减。当进程调用
malloc等函数分配内存时,新分配的内存就被动态加入到堆上。当利用free等函数释放内存时,被释放的内存从堆中被剔除。但是为此付出的代价是分配速度较慢,而且会形成内存碎片。 - Go 通过编译器分析代码的特征和代码的生命周期,决定应该使用堆还是栈来进行内存分配。
- 如果变量在函数外部没有引用,则优先放在栈中;否则放在堆中;如果编译器无法确定是否被外部引用,同样会放在堆内存中,如
interface{}
GC
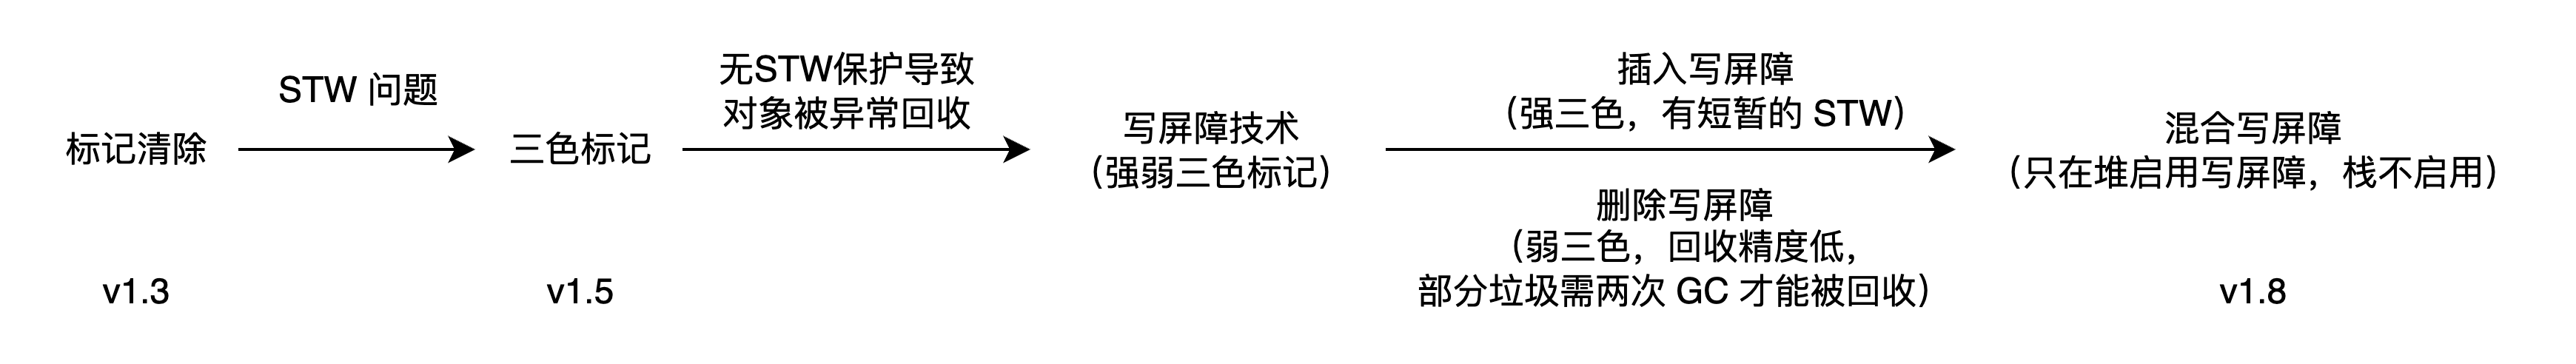
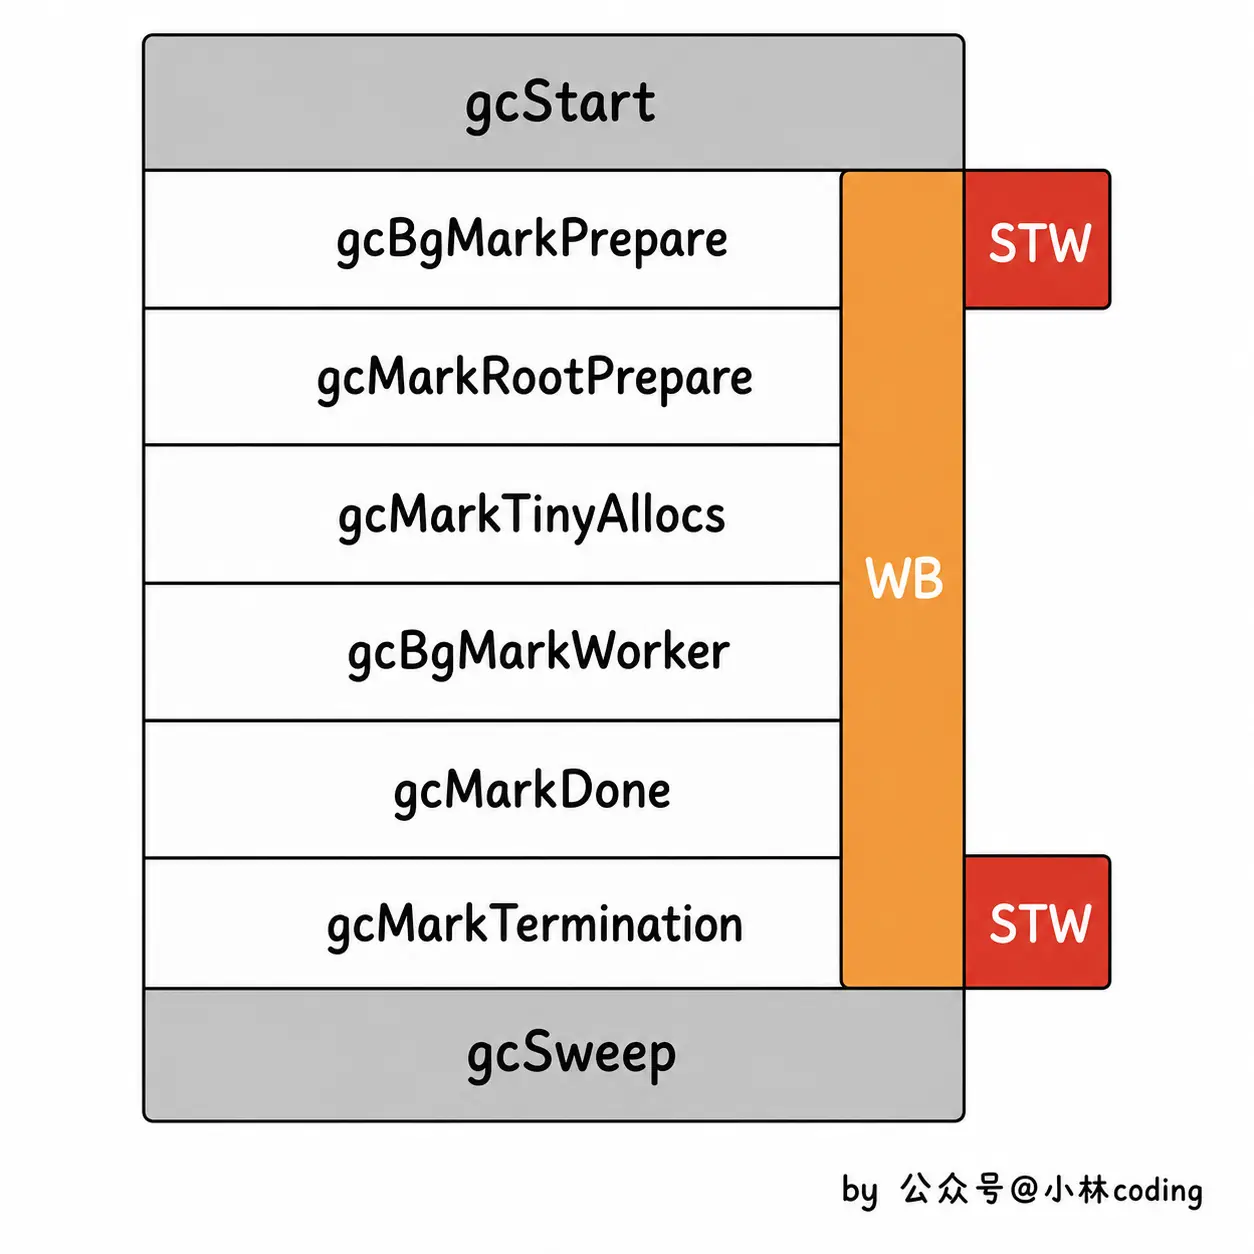 Go 的 GC 采用三色标记和混合写屏障实现。如果在整个标记期间都 STW,会导致明显的暂停延迟,因此 Go 仅在标记的开始(开启写屏障)和结束(确认标记完成)有短暂的 STW,而并发标记期间通过混合写屏障跟踪业务 goroutine 对引用关系的修改,保证标记的准确性。
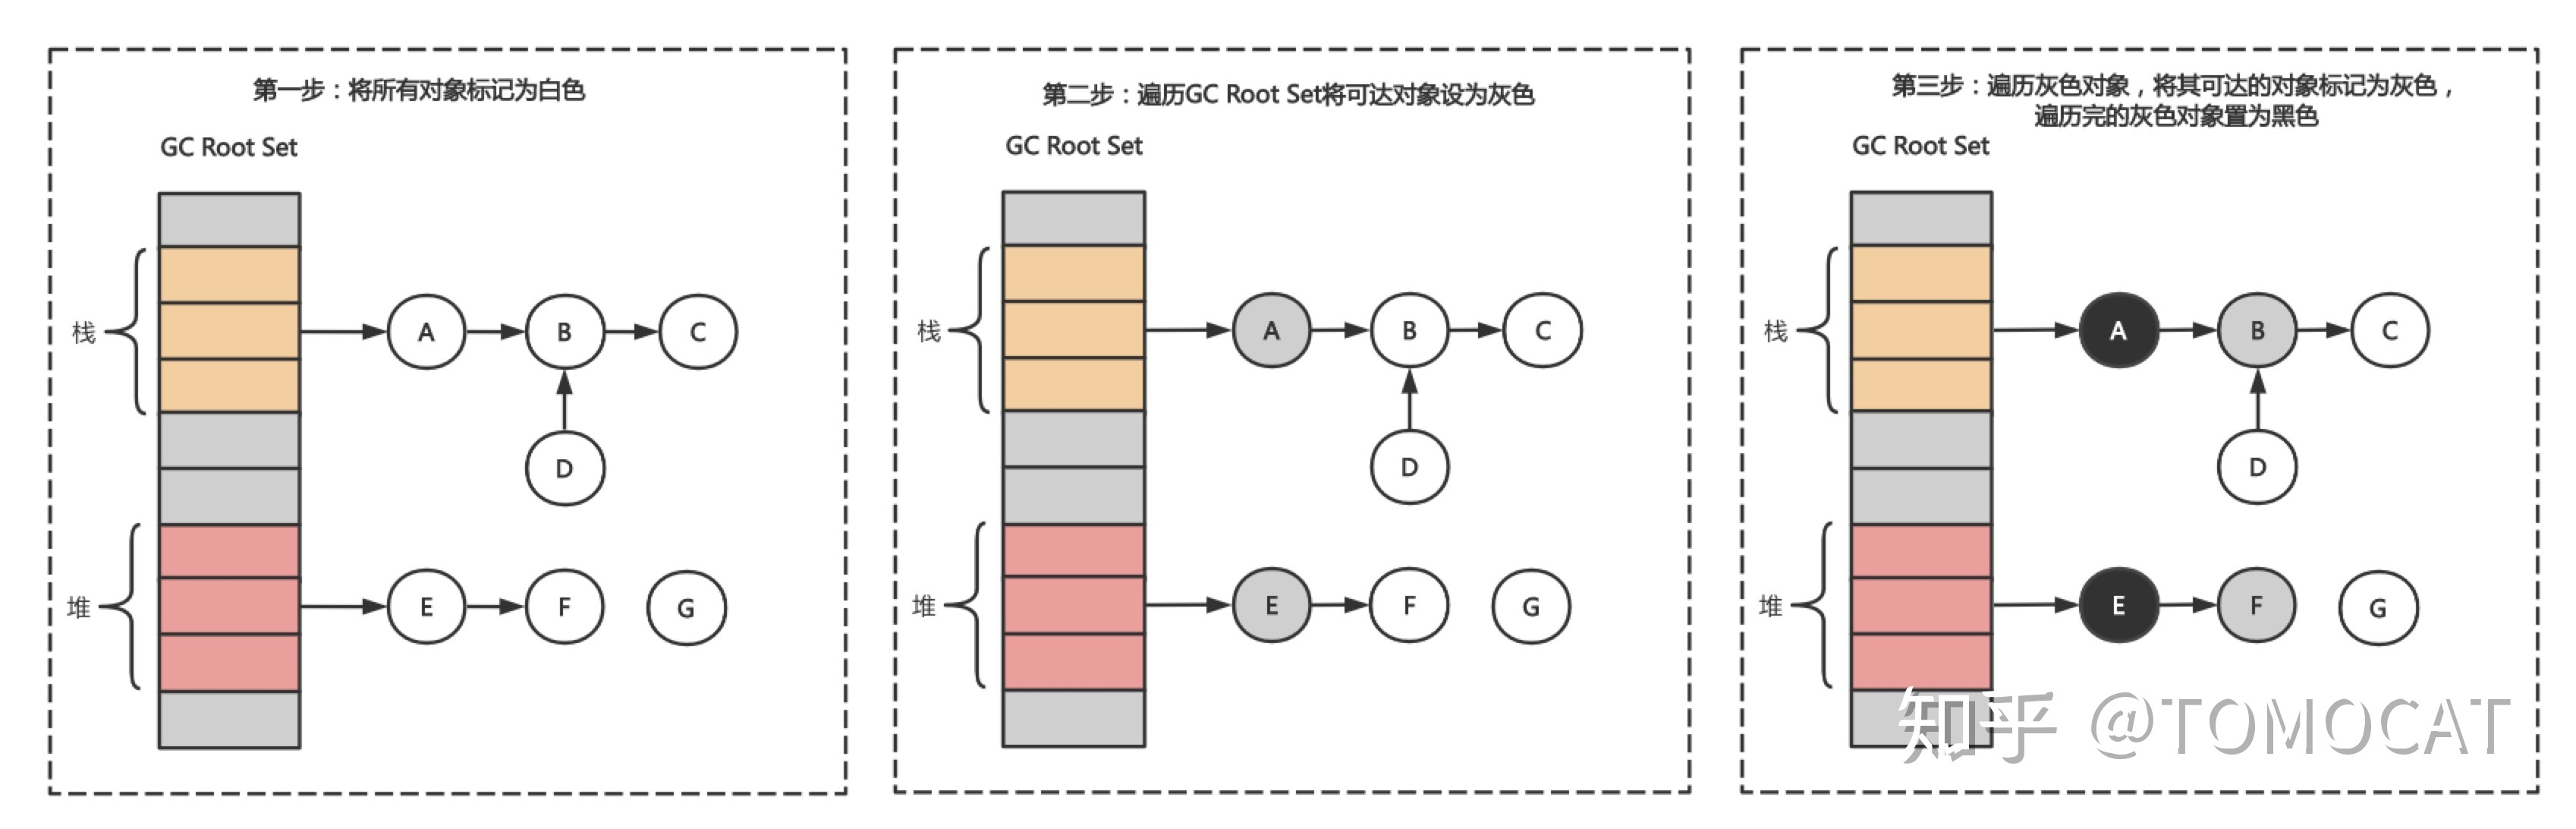
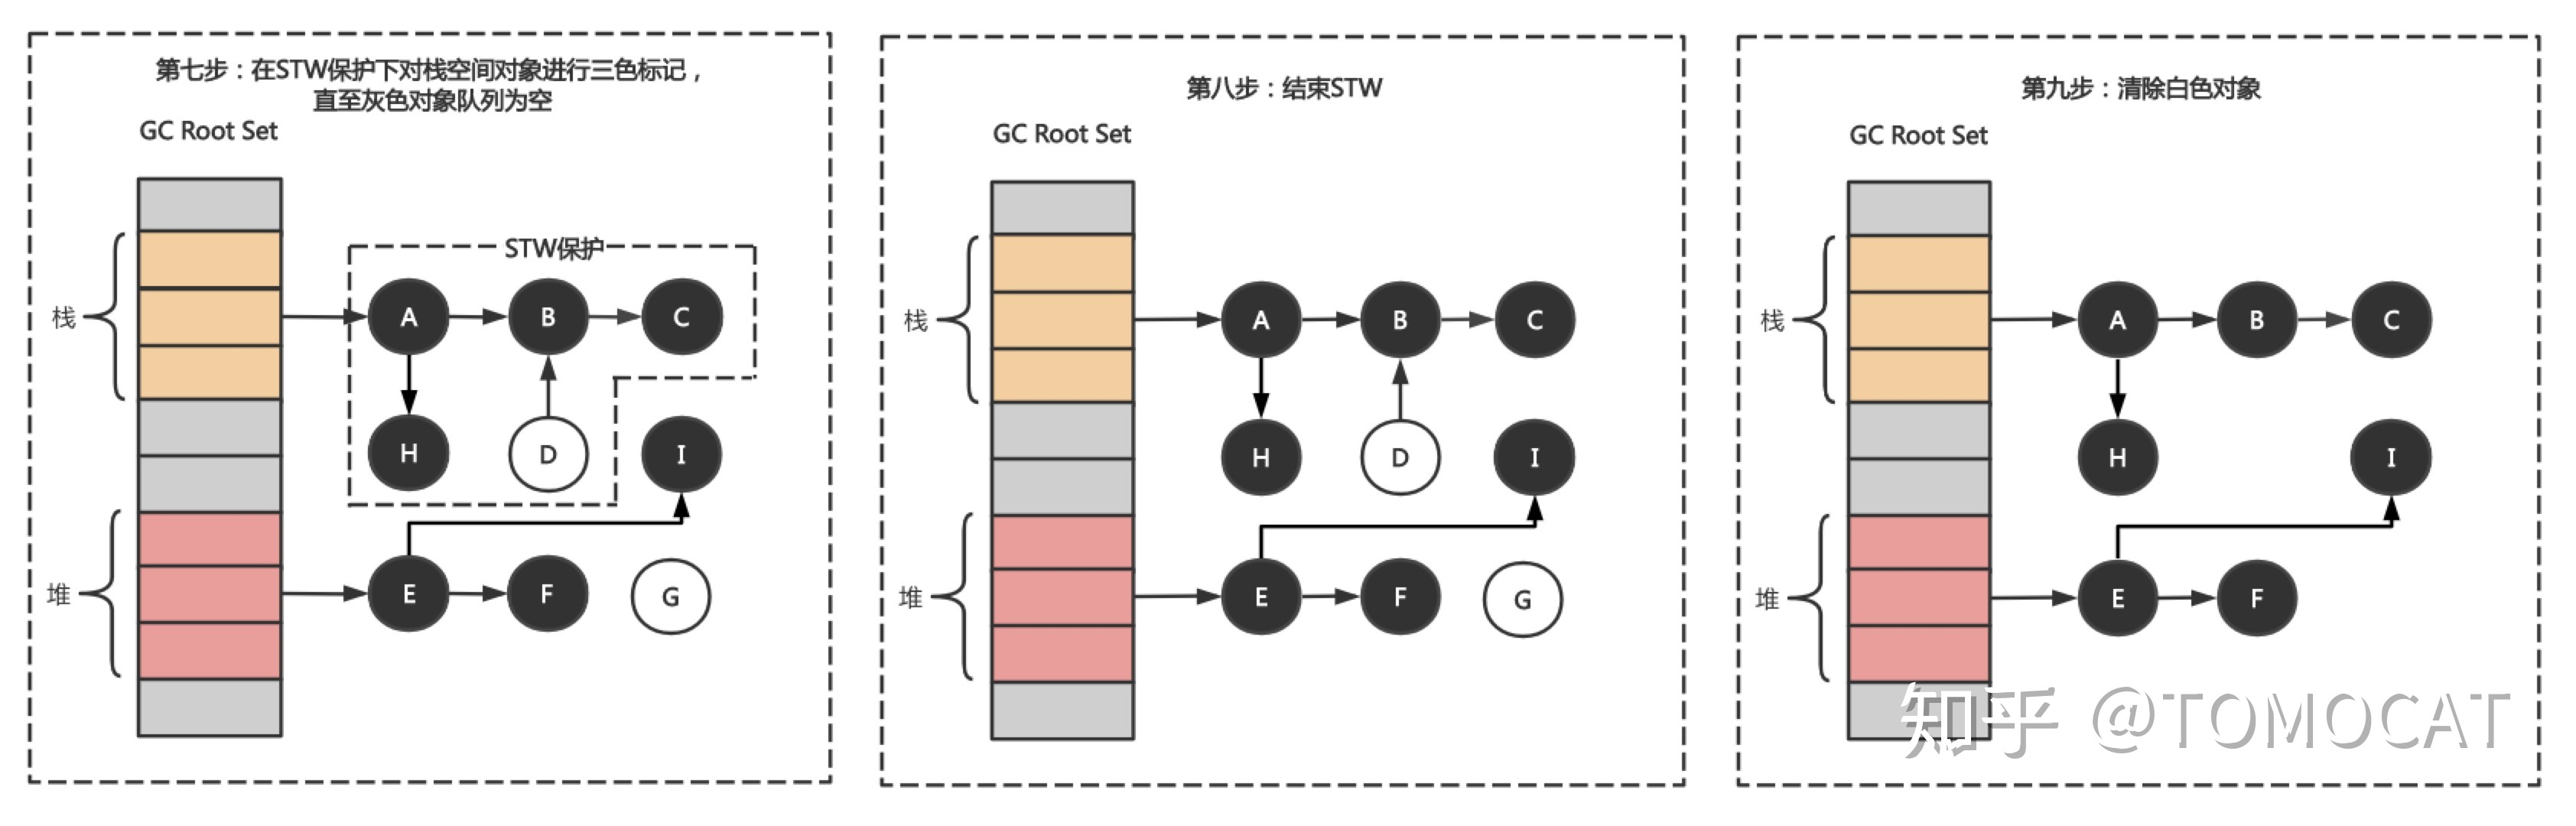
三色标记法的操作步骤为:
- 新创建的对象默认颜色均为白色
- 从根节点遍历所有对象,深度为 1,并将可达对象由白色标记为灰色
- 遍历灰色对象,并将可达的节点标记为灰色,当前节点标记为黑色
- 不断遍历灰色对象,直至所有对象只有黑色和白色为止
- 回收所有标记为白色的不可达对象
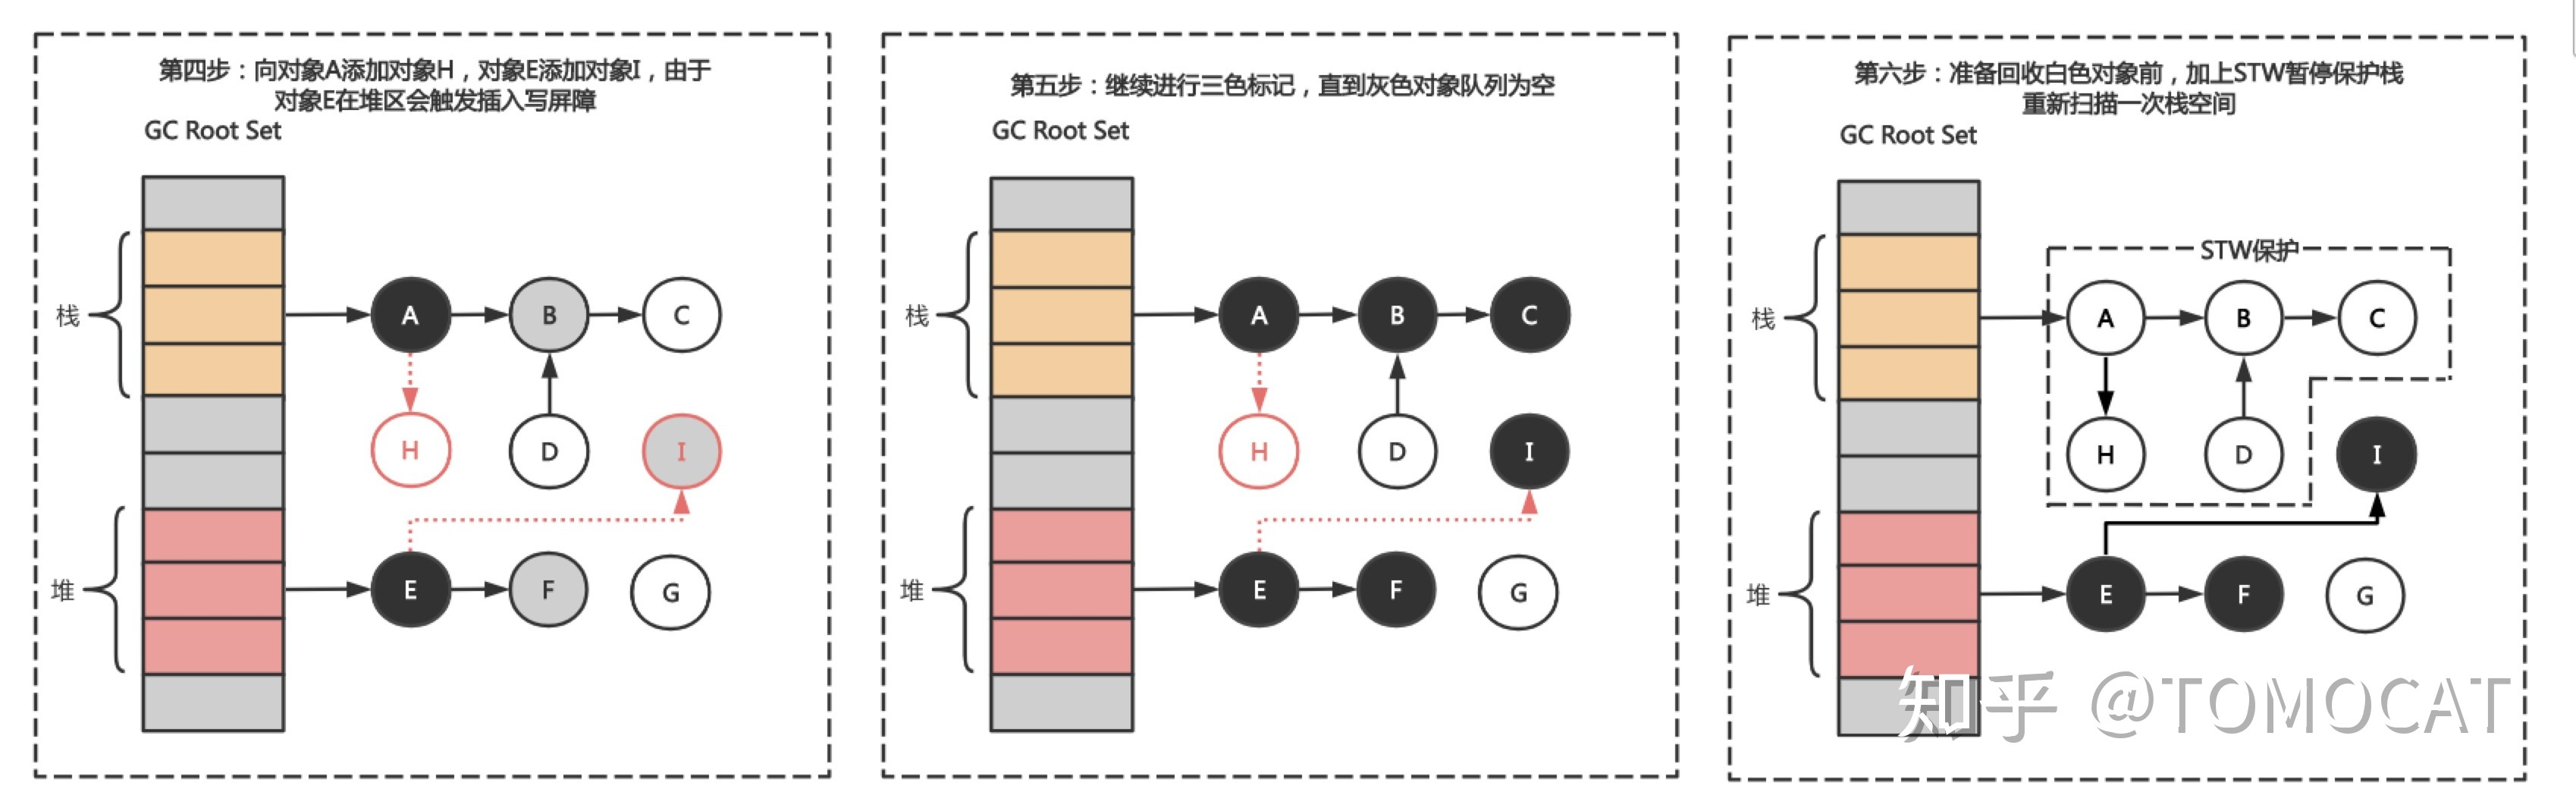
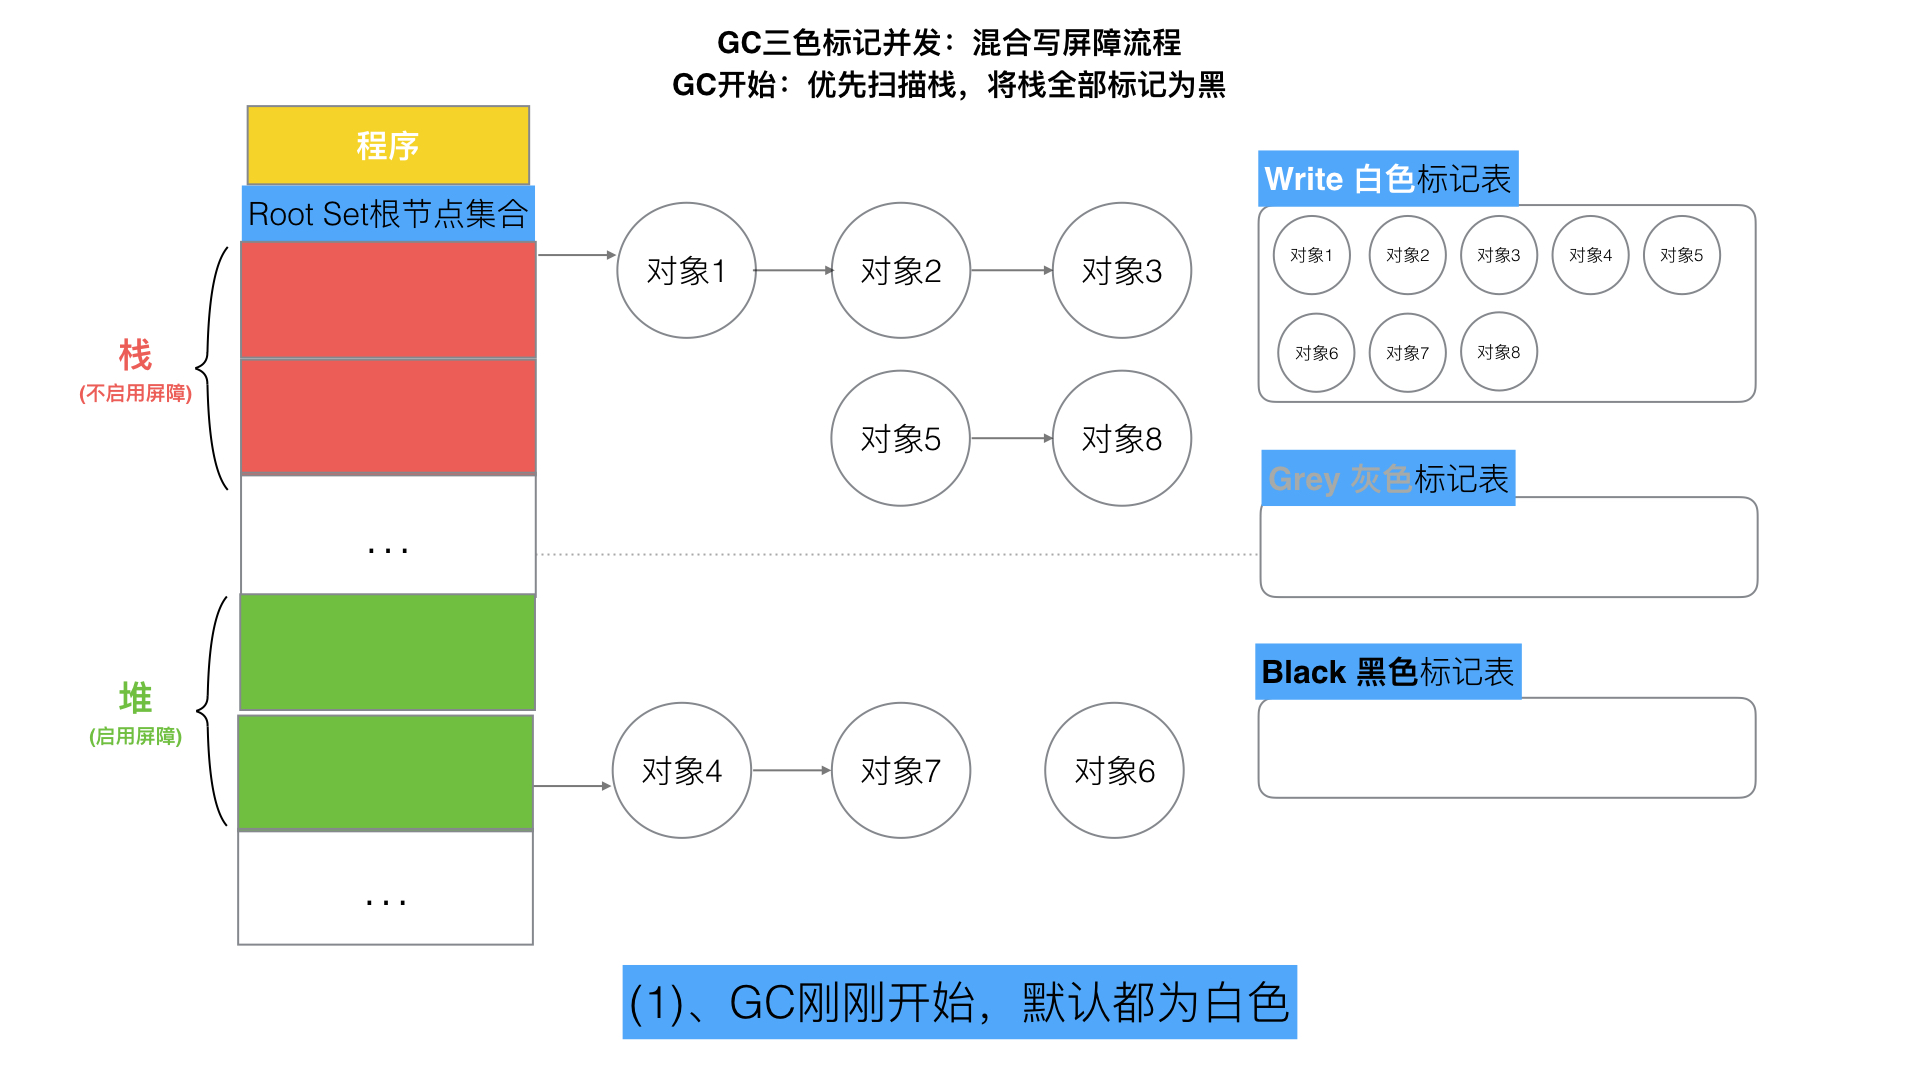
Go 1.8 版本开始采用混合写屏障机制,避免了插入写屏障(结束时需要 STW 来重新扫描栈,标记栈上引用的白色对象的存活)和删除写屏障(回收精度低)的缺点,同时只在堆上启用屏障技术,栈上则不启用,整体过程几乎不需要 STW,因此效率较高
- GC 开始将栈上的对象全部扫描并标记为黑色 (之后不再进行第二次重复扫描,无需 STW)
- GC 期间,任何在栈上创建的新对象,均为黑色
- 被添加或删除的对象标记为灰色
三色标记 1 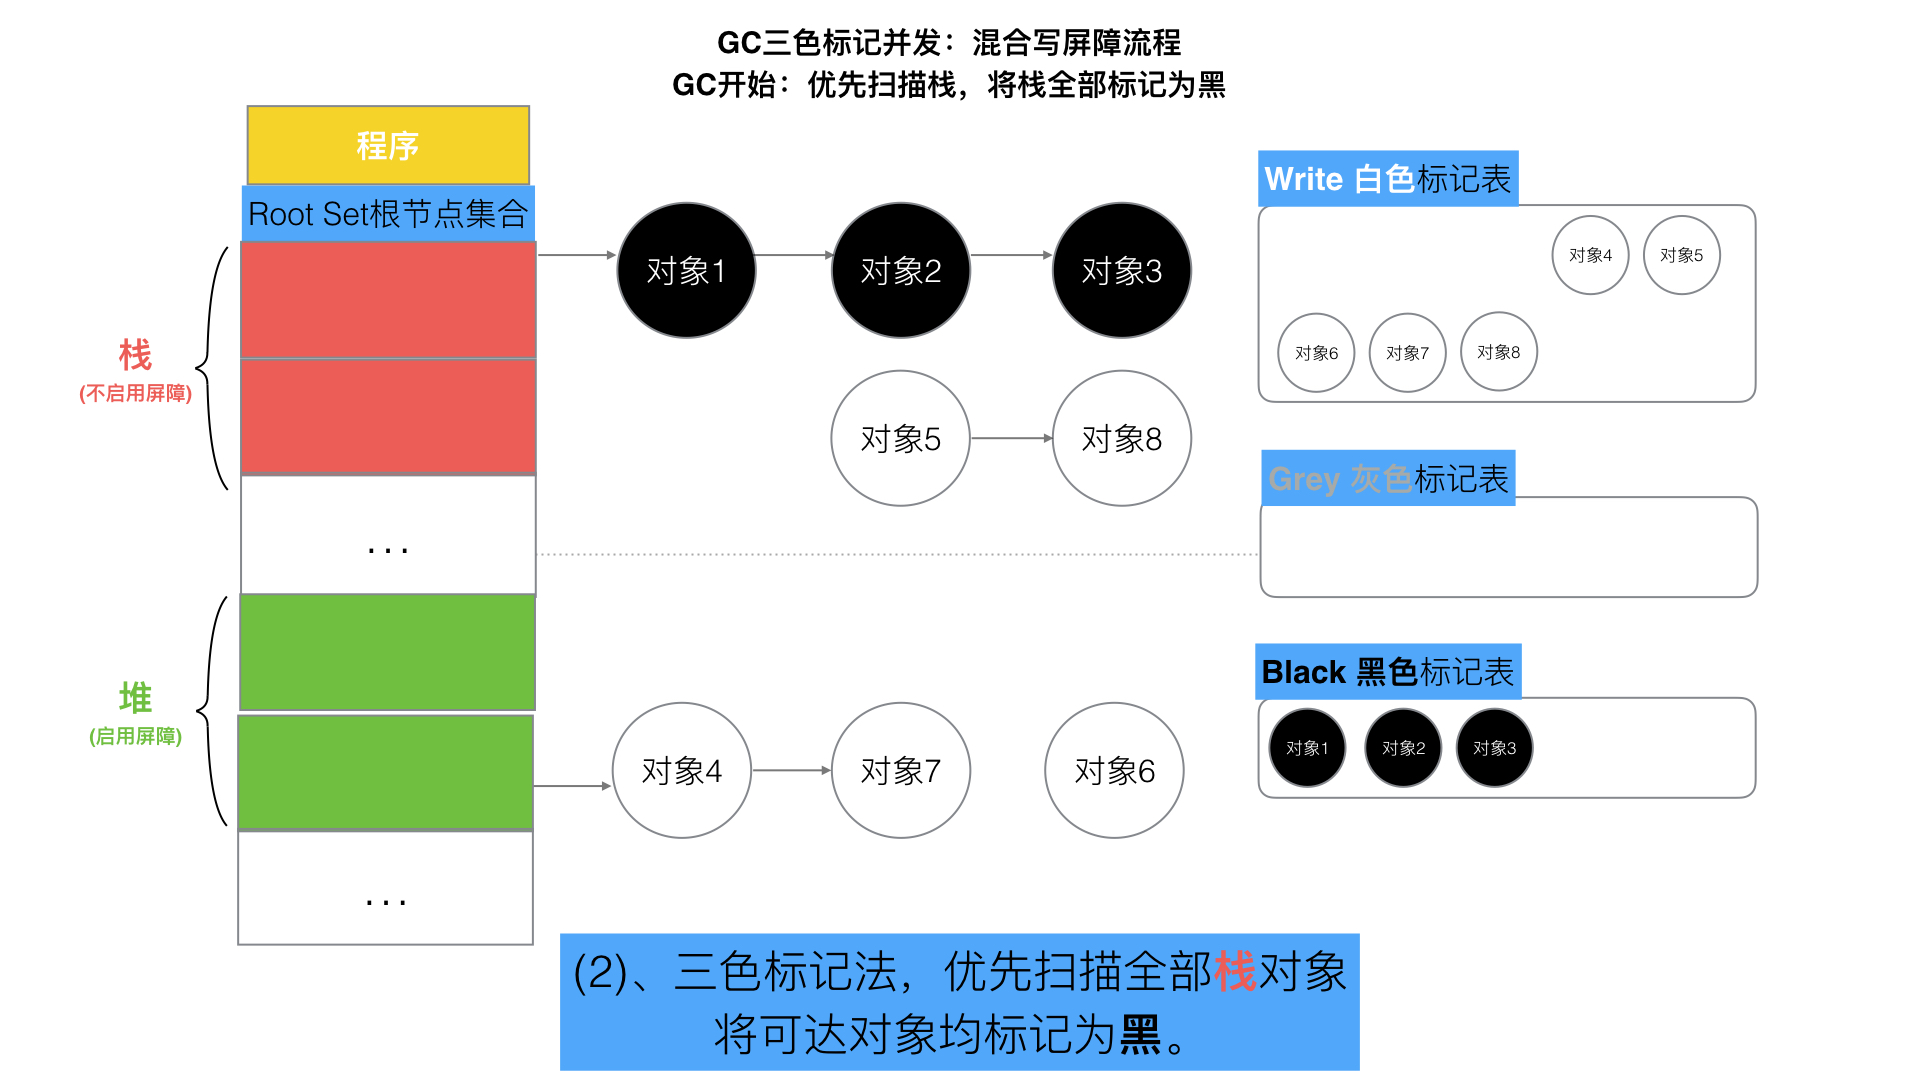
三色标记 2
GC 的触发条件有两个:
- 超过内存大小阈值
- 达到定时时间
调度器
GMP
- G(Goroutine)是 Go 语言调度器中待执行的任务,它在运行时调度器中的地位与线程在操作系统中差不多,但是它占用了更小的内存空间,也降低了上下文切换的开销
- M(Machine)是操作系统线程。调度器最多可以创建 10000 个线程,但是其中大多数的线程都不会执行用户代码(可能陷入系统调用),最多只会有
GOMAXPROC个活跃线程能够正常运行- 在默认情况下,一个四核机器会创建四个活跃的操作系统线程,每一个线程都对应一个运行时中的
runtime.m结构体。 - 在大多数情况下,我们都会使用 Go 的默认设置,也就是线程数等于 CPU 数,默认的设置不会频繁触发操作系统的线程调度和上下文切换,所有的调度都会发生在用户态,由 Go 语言调度器触发,能够减少很多额外开销。
- 在默认情况下,一个四核机器会创建四个活跃的操作系统线程,每一个线程都对应一个运行时中的
-
P(Processor)是线程和 Goroutine 的中间层,它能提供线程需要的上下文环境,也会负责调度线程上的等待队列,通过处理器 P 的调度,每一个内核线程都能够执行多个 Goroutine,它能在 Goroutine 进行一些 I/O 操作时及时让出计算资源,提高线程的利用率。
-
Go 用本地和全局两个队列来存放待运行的协程任务,前者用数组构成的环形链表,最多可以存储 256 个待执行任务;后者只有在本地队列没有剩余空间时才会使用
-
调度器的设计策略(视频教程)
- 任务窃取调度器:
- 基于工作窃取的多线程调度器将每一个线程绑定到了独立的 CPU 上,这些线程会被不同处理器管理,不同的处理器通过工作窃取对任务进行再分配实现任务的平衡,也能提升调度器和 Go 语言程序的整体性能。
- 调度顺序:本地队列 -> 全局队列 -> 网络轮询器(
netpoll)-> 其他队列窃取一半 - 在某些情况下,Goroutine 不会让出线程,进而造成饥饿问题。
- 时间过长的 STW 会导致程序长时间无法工作
- 抢占式调度器:
- 基于协作的抢占式调度器 - 1.2 ~ 1.13。某个协程不释放 CPU 会导致其它协程的饥饿问题
- 基于信号的抢占式调度器 - 1.14 ~ 至今。即使某个协程不释放 CPU,也会被调度器强制释放
- 任务窃取调度器:
-
调度器的启动
- M0:程序启动后编号为 0 的第一个线程
- G0:启动 M 时,第一个创建的协程,每个 M 都有属于自己的 G0。G0 仅用于调度其它协程,G0 不执行任何函数
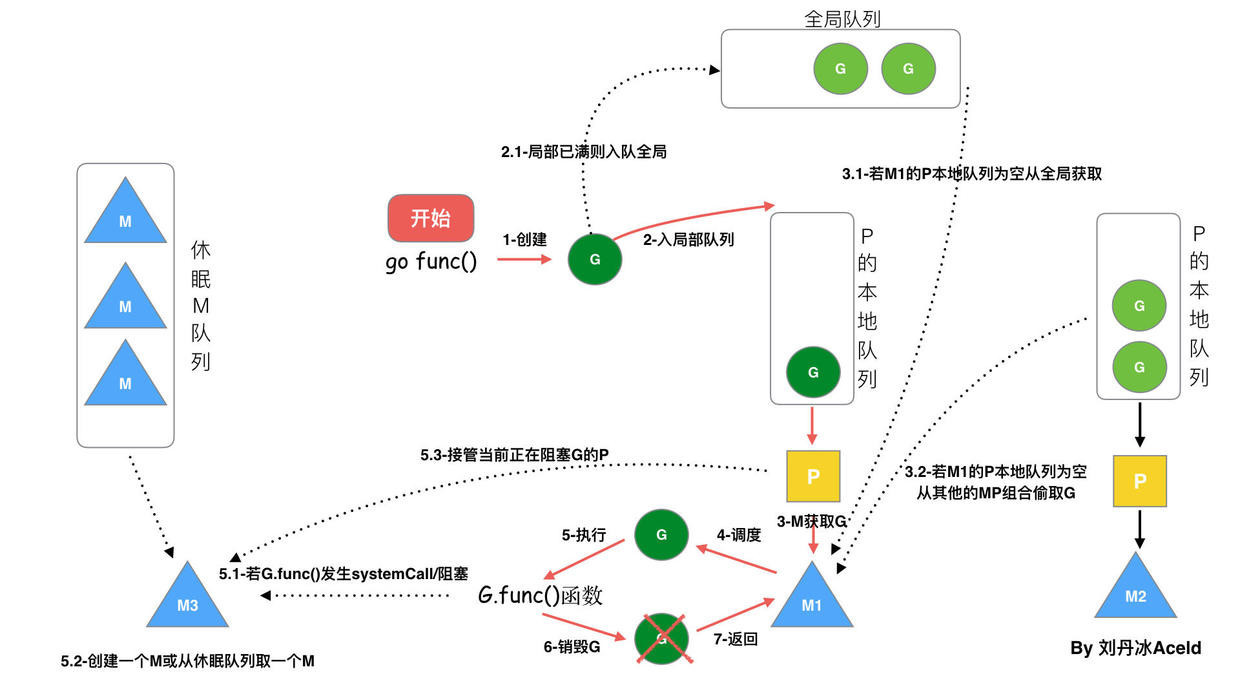
GMP 能不能去掉 P 层?
如果去掉P,直接变成 GM 模型,所有 M 都需要从全局队列中获取 goroutine,这就需要全局锁保护。这样会引入大量的锁竞争,导致调度器的性能下降。
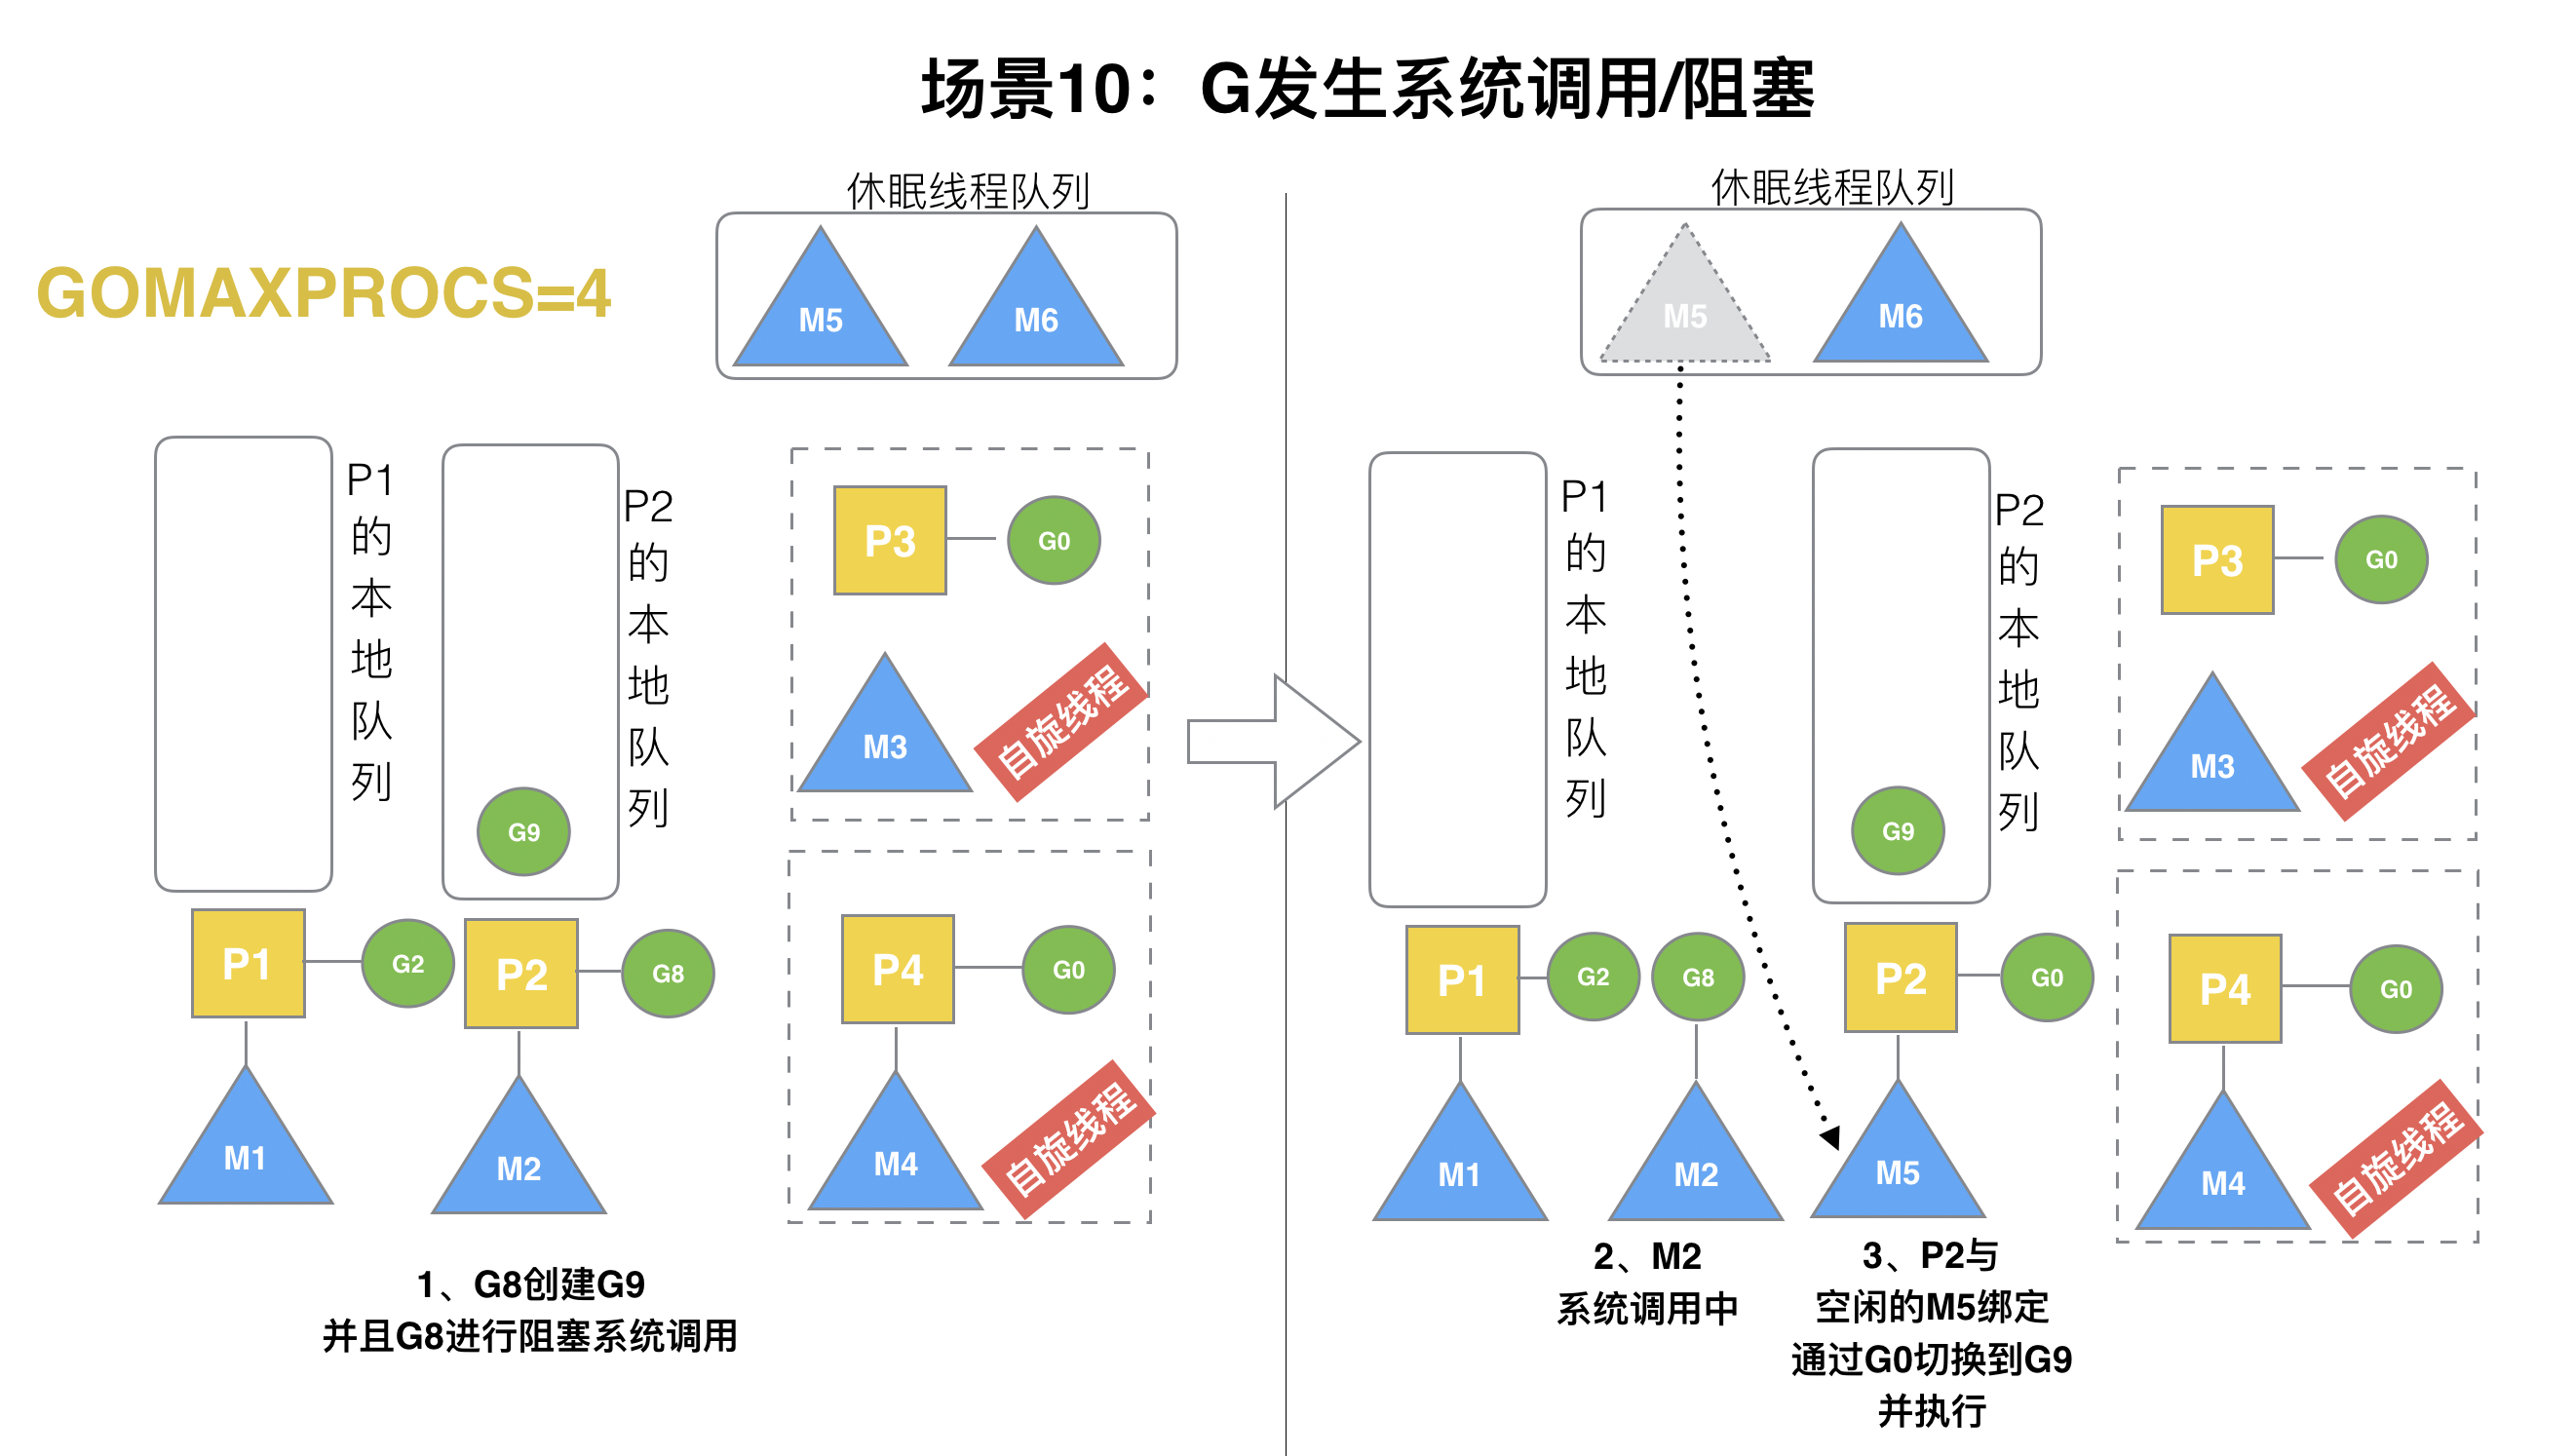
阻塞调用 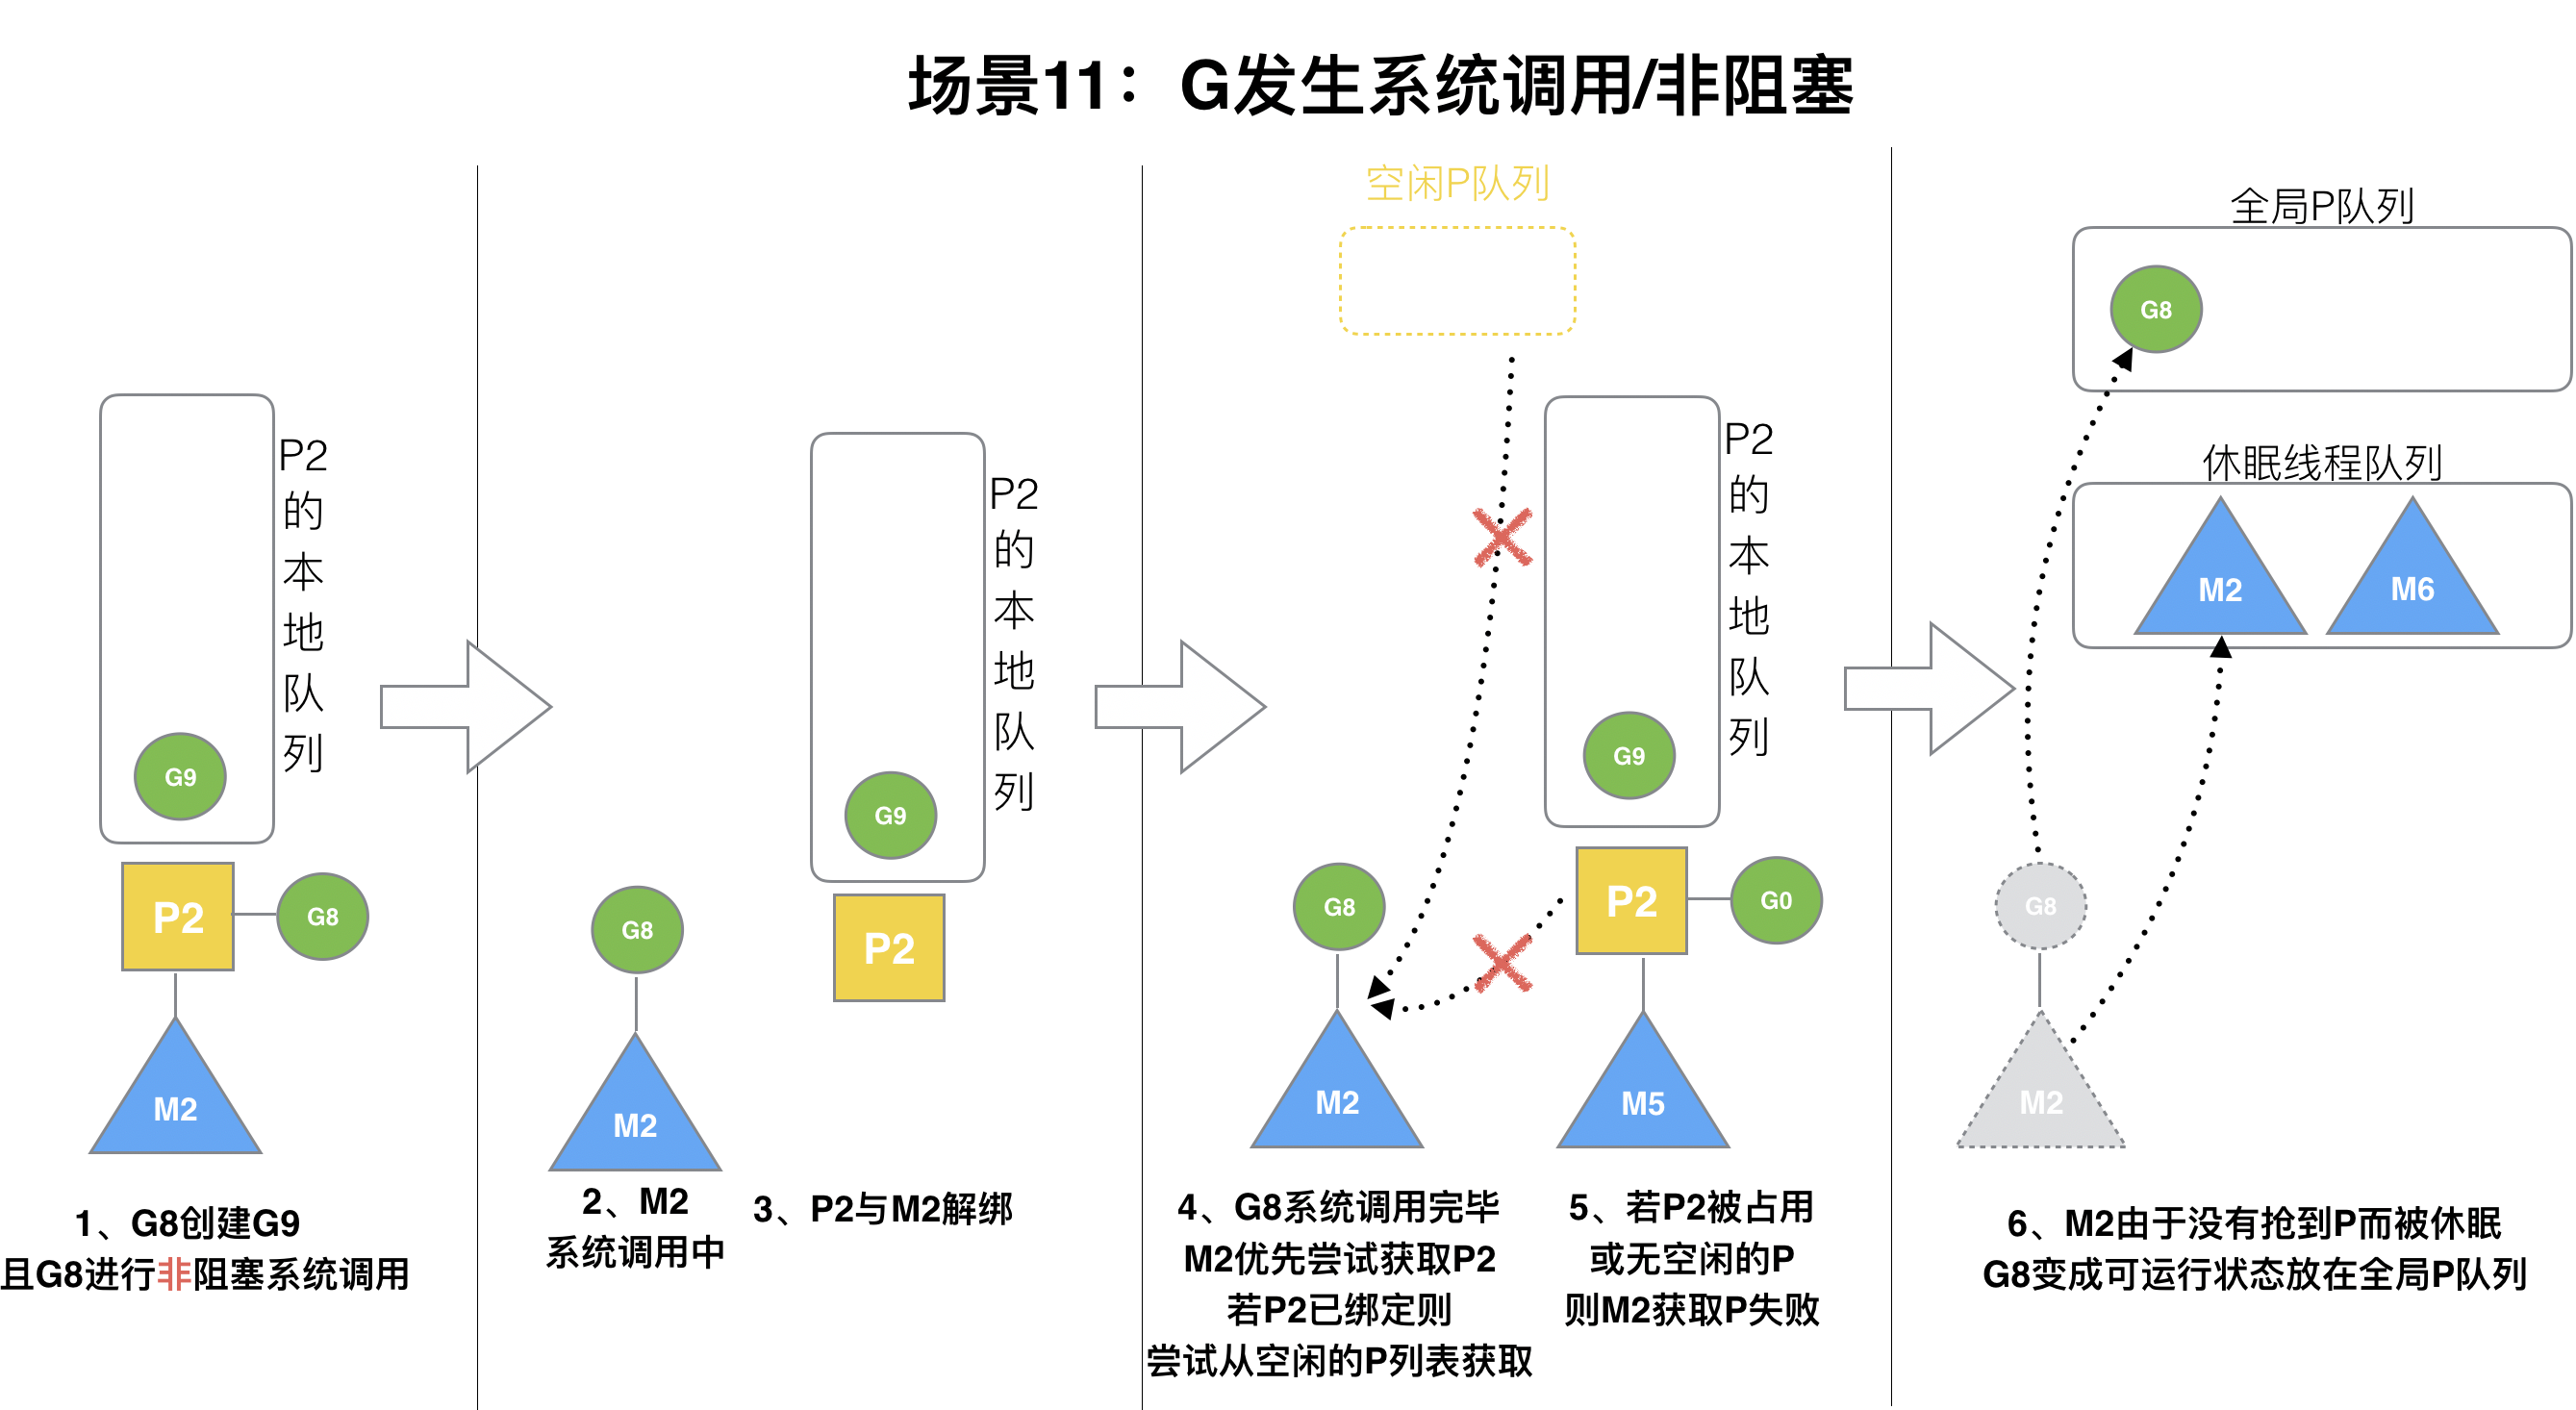
非阻塞调用
Mutex
Go 的 Mutex 主要有两种模式:
| 模式 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| 正常 | 通过新到的 Goroutine 自旋来避免频繁唤醒和睡眠 Goroutine 的开销 | 吞吐量高 | 队列尾端任务延迟 |
| 饥饿 | 新到的 Goroutine 在队列中排队 | 公平 | 吞吐量低 |
Mutex 不断在这两种模式中切换,当等待队列头部的 goroutine 等待时间超过 1ms 时,切换到饥饿模式;当获得锁的 waiter 是最后一个等待者、或其等待时间不足 1ms 时,切换回正常模式。
生产常见故障
Go 的线上故障多由资源泄露、阻塞和并发控制不当引起,往往不报错,属于**“静默”**问题。这些问题在本地低流量下很难复现,上线后容易集中爆发。
排查工具
绝大多数 Go 线上故障的定位都绕不开 pprof。在生产环境暴露一个受鉴权保护的 net/http/pprof 端点,可以快速分析 Goroutine 堆积在哪里、谁在占内存、谁在消耗 CPU。
| 现象 | 可能的故障 | 排查手段 |
|---|---|---|
| Goroutine 数量持续上涨 | Goroutine 泄露 | goroutine profile |
| RSS 或容器内存持续上涨,最终被 OOMKilled | 内存泄露 | 对比两次 heap profile,或观察 GODEBUG=gctrace=1 输出 |
| 程序无响应,CPU 和内存可能正常,但接口全部超时 | 死锁 | goroutine?debug=2 查看完整堆栈 |
进程崩溃并输出 fatal error: concurrent map ... |
数据竞争 | 崩溃堆栈,测试时开启 -race |
| 服务变慢但 CPU 不高 | 锁竞争 | mutex、block profile |
接口 RT 飙升,报 connection pool timeout |
连接池耗尽 | 连接池指标 |
| CPU 高或延迟抖动 | 性能与 GC 问题 | CPU profile,gctrace |
# 查看 Goroutine 堆积在哪里,debug=2 输出每个 Goroutine 的完整堆栈
curl 'http://localhost:6060/debug/pprof/goroutine?debug=2'

# 采集 30 秒 CPU profile
go tool pprof 'http://localhost:6060/debug/pprof/profile?seconds=30'

# 对比两次堆快照,查看期间内存增长
go tool pprof -base heap1.pb.gz heap2.pb.gz
mutex和blockprofile 默认关闭,需要先调用runtime.SetMutexProfileFraction和runtime.SetBlockProfileRate开启。
Goroutine 泄露
| 原因 | 修复 |
|---|---|
| 无限创建:每个请求或任务都启动 Goroutine,没有并发上限 | 对外入口用带缓冲的 channel 或协程池限流 |
| 阻塞不退出:向无接收者的 channel 发送,或从无发送者的 channel 接收,且没有超时或退出分支 | 所有阻塞操作都带 context 超时或 select 退出分支 |
| HTTP 请求中启动后台 Goroutine,没有取消机制 | 传入 context,监听 ctx.Done() 退出 |
sync.WaitGroup 的 Add 和 Done 计数不匹配,导致 Wait() 永久阻塞 |
在启动 Goroutine 前调用 Add,在 Goroutine 内 defer wg.Done() |
内存泄露
| 原因 | 修复 |
|---|---|
资源未关闭:最典型的是 http.Get 后忘记关闭 resp.Body,文件、数据库连接同理,导致连接和文件句柄泄露 |
defer resp.Body.Close() |
定时器未 Stop:time.Ticker、time.Timer 用完未调用 Stop(),底层资源无法回收(Go 1.23 起已修复,需 go.mod 声明 go 1.23 及以上) |
defer ticker.Stop() |
| 全局 map/slice 只增不减 | 设置容量上限或过期淘汰 |
| map 不缩容:删除元素只是标记删除,底层 bucket 不会缩减,map 曾经很大时内存占用仍然很高 | 定期重建 map |
子切片引用大数组:如 hugeSlice[:2] 持有底层大数组的引用,整个数组无法回收 |
用 append([]T(nil), hugeSlice[:2]...) 或 slices.Clone() 拷贝所需数据 |
| 大对象一次性读入内存:如文件下载服务处理大文件时直接触发 OOM(不算泄露,但现象相同) | 用 io.Copy 流式处理 |
排查时对比两次 heap profile,或观察 GODEBUG=gctrace=1 输出的 #->#-># MB,其中最后一个值(存活堆大小)持续上升就说明存在泄露。Goroutine 泄露也会导致内存上涨,建议同时查看 Goroutine 数量。
死锁
死锁(deadlock)本质是:一组 goroutine 互相等待某个永远不会发生的事件,导致所有相关 goroutine 无法继续执行。
所有 goroutine 都阻塞时,运行时会报 fatal error: all goroutines are asleep - deadlock! 并退出。但线上服务总有其他 goroutine 在运行或等待网络,运行时检测不到局部死锁,程序只是卡住,不会有任何错误或堆栈,需要通过 goroutine?debug=2 找到阻塞在同一把锁或同一个 channel 上的 goroutine。
Go 里最常见的死锁场景主要集中在:锁、channel、WaitGroup、资源顺序。
锁
func main() {
    var mu sync.Mutex

    mu.Lock()
    defer mu.Unlock()

    mu.Lock() // 死锁
}
func update() {
    mu.Lock()

    doSomething()

    // 忘记 Unlock()
}
goroutine 1:
a.Lock()
b.Lock()
goroutine 2:
b.Lock()
a.Lock()
导致相互持有对方的锁,永远等待。解决方式则是规定锁的顺序,比如固定先加 a 锁,再加 b 锁。
mu.RLock()

// 此时另一个 goroutine 调用 mu.Lock(),等待读锁释放

mu.RLock() // 被排队的写锁阻塞,形成循环等待
sync.RWMutex 有写锁排队时会阻塞新的读锁,因此禁止递归加读锁。这种死锁只在特定并发下出现,线上表现为 goroutine 堆积。
channel
- Channel 无人发送
- 无缓冲 Channel 无人接收
- Channel 缓冲区满
- 从未关闭 channel 导致等待
- 发送方和接收方互相等待对方先行动
其他
- 忘记
Done()导致wg.Wait()永久等待 select {}导致永久阻塞
数据竞争与锁竞争
| 原因 | 修复 |
|---|---|
Map 并发读写:内置 map 非并发安全,多个 Goroutine 同时读写会触发 fatal error: concurrent map read and map write,进程直接崩溃,且无法被 recover 捕获 |
用 sync.RWMutex 保护,或使用 sync.Map;测试时开启 -race |
| 锁粒度不当:用全局大锁包裹耗时的 IO 或网络请求,高并发下所有请求排队执行,吞吐量暴跌,表现为“服务变慢但 CPU 不高” | 缩小临界区,不在持锁时做 IO;或拆分锁 |
下游依赖
| 原因 | 修复 |
|---|---|
连接池过小:例如 go-redis 的 PoolSize 设置过小,高峰期大量 Goroutine 拿不到连接,抛出 connection pool timeout,接口 RT 飙升 |
按峰值并发调整连接池大小,排查占用连接的慢查询 |
| 重试风暴:下游变慢时,上游多层重试叠加,瞬间放大流量,压垮下游或自身 | 限制重试次数,使用指数退避加随机抖动,只在一层重试,配合熔断 |
性能与 GC 问题
| 原因 | 修复 |
|---|---|
| GC 压力过大:对象分配速率过快,GC 频繁运行,后台标记和标记辅助(mark assist)抢占业务 CPU,导致接口延迟抖动、超时率上升 | 用 heap profile 的 alloc_space 找到分配热点,减少分配或用 sync.Pool 复用对象;调整 GOGC、GOMEMLIMIT |
CPU 热点:某个函数占用大量 CPU 时间,如低效的正则、序列化大对象、for + select default 空转 |
用 CPU profile 定位并优化 |
版本变化
| 版本 | 时间 | 重要变化 |
|---|---|---|
| 1.5 | 2015.08 | 编译器和运行时从 C 改为 Go 实现(自举);实验性 vendor 目录支持 |
| 1.11 | 2018.08 | 引入 Go Modules(实验性);支持 WebAssembly |
| 1.13 | 2019.09 | fmt.Errorf 支持 %w 错误包装;Module 代理和校验数据库上线 |
| 1.16 | 2021.02 | Modules 默认开启,废弃 GOPATH 模式;go:embed 嵌入静态文件 |
| 1.18 | 2022.03 | 泛型(Type Parameters);内置 Fuzzing 测试;Go Workspaces |
| 1.21 | 2023.08 | PGO(Profile-Guided Optimization)正式可用;新增 slog、slices、maps 标准库 |
| 1.22 | 2024.02 | 修复循环变量捕获问题(每次迭代独立变量);for range 支持整数 |
| 1.23 | 2024.08 | 迭代器(iter 包);修复 time.Timer/Ticker 未 Stop 时无法被 GC 回收的泄漏问题 |
| 1.24 | 2025.02 | 泛型类型别名;go.mod 中可直接声明工具依赖(tool 指令) |
Gin
gin.Context不是线程安全的,不能直接传递给异步的Goroutine。因为gin为了减少GC压力,使用了sync.Pool复用Context对象。当请求处理结束返回后,Context会被重置并放回池中,供下一个请求使用。如果异步Goroutine继续读写这个Context,会导致数据竞争或拿到脏数据。- 洋葱模型
常见题目
交替打印
双 channel 缓冲解法:
// channel 仅同步信号,不传递数据
// 推荐解法
func main() {
    ch0 := make(chan struct{}, 1)
    ch1 := make(chan struct{}, 1)

    var wg sync.WaitGroup

    wg.Go(func() {
        for range 5 {
            <-ch0
            fmt.Println(0)
            ch1<-struct{}{}
        }
    })

    wg.Go(func() {
        for range 5 {
            <-ch1
            fmt.Println(1)
            ch0<-struct{}{}
        }
    })

    ch0<-struct{}{}

    wg.Wait()
}
// channel 传递数据
func main() {
    ch0 := make(chan int, 1)
    ch1 := make(chan int, 1)

    var wg sync.WaitGroup

    wg.Go(func() {
        for range 5 {
            num := <-ch0
            fmt.Println(num)
            ch1 <- 1
        }
    })

    wg.Go(func() {
        for range 5 {
            num := <-ch1
            fmt.Println(num)
            ch0 <- 0
        }
    })

    ch0 <- 0

    wg.Wait()
}
无缓冲解法:
func main() {
    ch := make(chan struct{}) // 必须无缓冲
    var wg sync.WaitGroup

    wg.Go(func() { // 只打 0
        for i := 0; i < 5; i++ {
            fmt.Print(0)
            ch <- struct{}{} // 阻塞,直到 B 收走
            <-ch             // 等 B 打完的回执,再进下一轮
        }
    })

    wg.Go(func() { // 只打 1
        for i := 0; i < 5; i++ {
            <-ch
            fmt.Print(1)
            ch <- struct{}{}
        }
    })

    wg.Wait()
}